Key-Value (KV) Cache
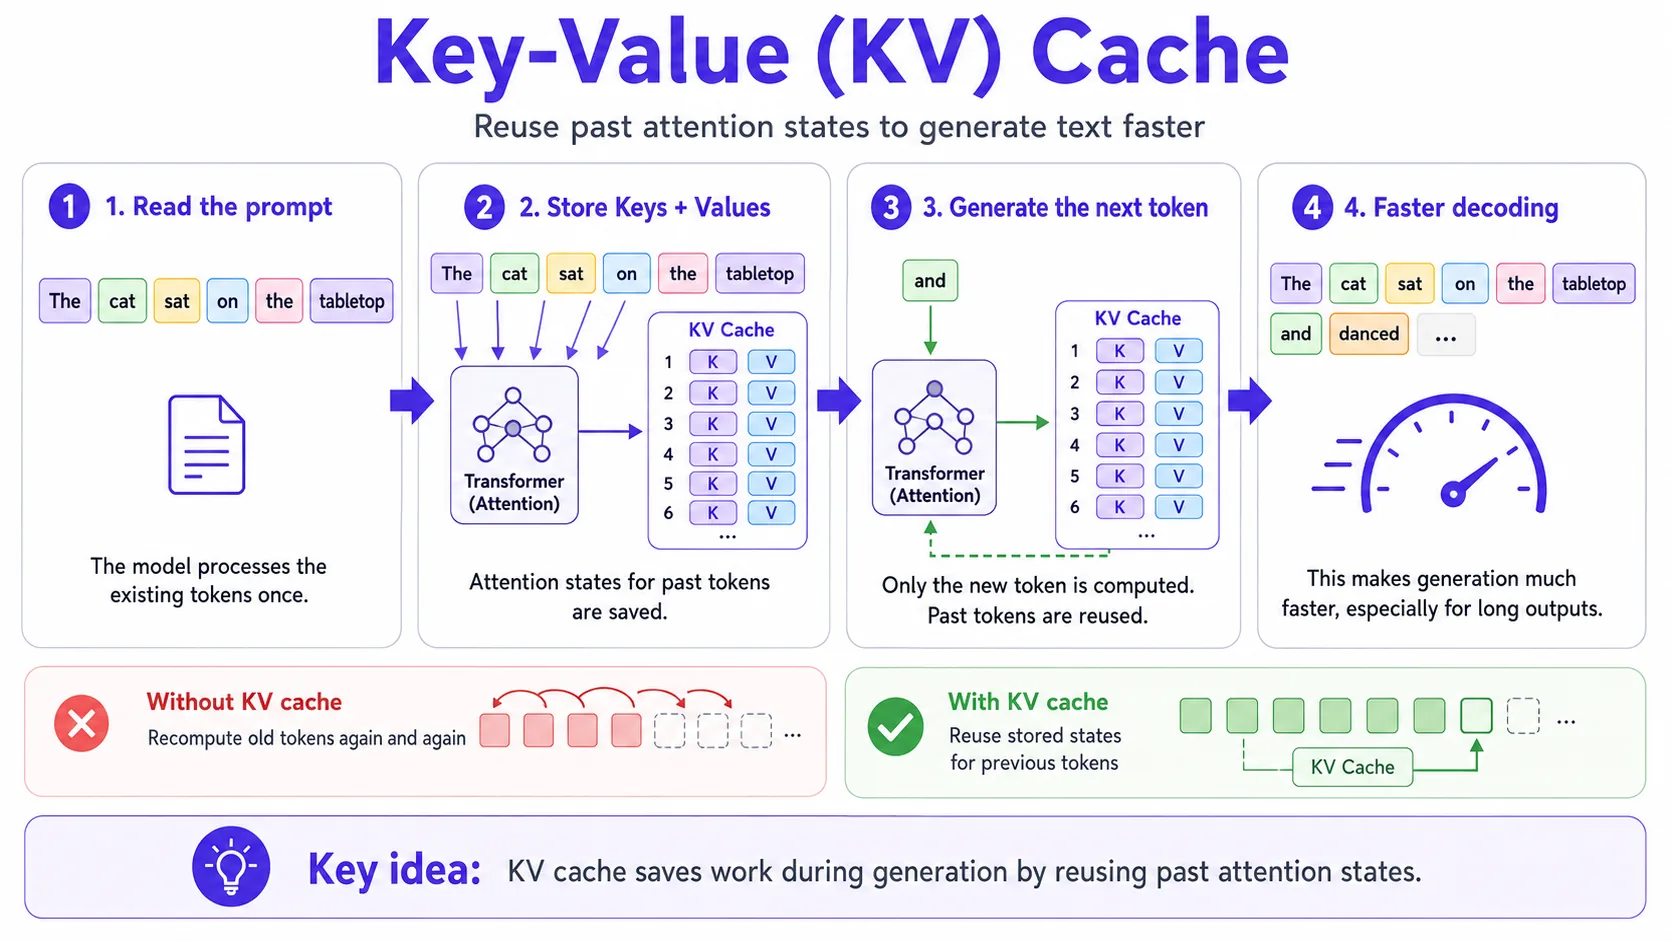
KV caching menyimpan tensor key-value dari token sebelumnya selama generasi autoregresif. Alih-alih menghitung ulang seluruh prefix untuk setiap token baru, model menggunakan kembali representasi yang sudah di-cache. Ini mengurangi latensi untuk output panjang, tetapi meningkatkan tekanan memory untuk setiap request aktif.
Control plane produksi untuk aplikasi LLM
Sistem LLM tingkat ahli bukan terutama soal satu model yang sempurna, melainkan routing, caching, evaluasi, pemeriksaan keamanan, dan feedback loop. Platform yang andal memutuskan model mana yang dipanggil, konteks apa yang diambil, kapan menggunakan model yang lebih murah, kapan melakukan eskalasi, dan bagaimana mendeteksi regresi.
Menormalkan request, menerapkan rate limit, menambahkan metadata tenant, dan memilih kandidat model.
Memilih model kecil, besar, atau khusus berdasarkan tingkat kesulitan tugas, anggaran latensi, dan risiko.
Memberi skor pada kualitas retrieval, kualitas jawaban, kesetiaan citation, keamanan, dan validitas skema.
Melacak prompt, chunk hasil retrieval, versi model, jumlah token, persentil latensi, dan mode kegagalan.
Mixture of Experts
Mixture of Experts mengarahkan token atau contoh melalui sebagian jaringan expert yang terspesialisasi. Pendekatan ini dapat meningkatkan jumlah parameter tanpa menggunakan setiap parameter untuk setiap token. Trade-off-nya mencakup kompleksitas routing, load balancing, communication overhead, dan debugging yang lebih sulit.
Speculative Decoding
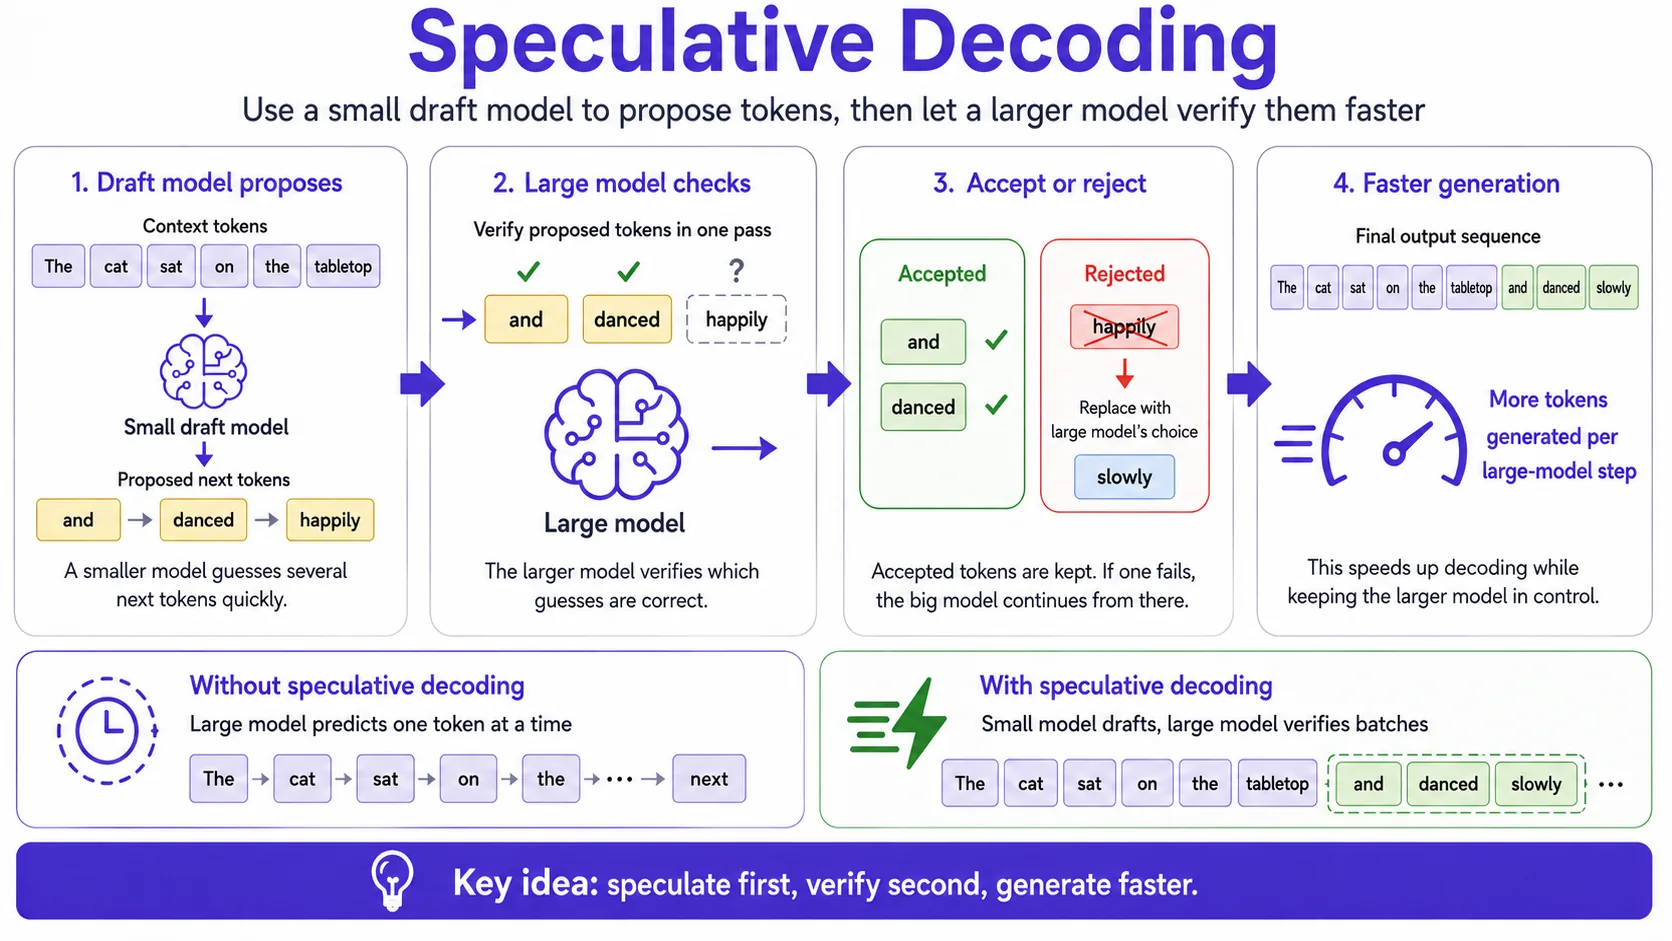
Speculative decoding menggunakan draft model atau prosedur draft untuk mengusulkan token, lalu target model memverifikasinya. Algoritme speculative sampling yang eksak dapat mempertahankan distribusi output target model; varian heuristik dapat menukar ketepatan dengan kecepatan. Peningkatan kecepatan bergantung pada acceptance rate, biaya draft, bentuk sequence dan batch, runtime, serta hardware.
Kuantisasi
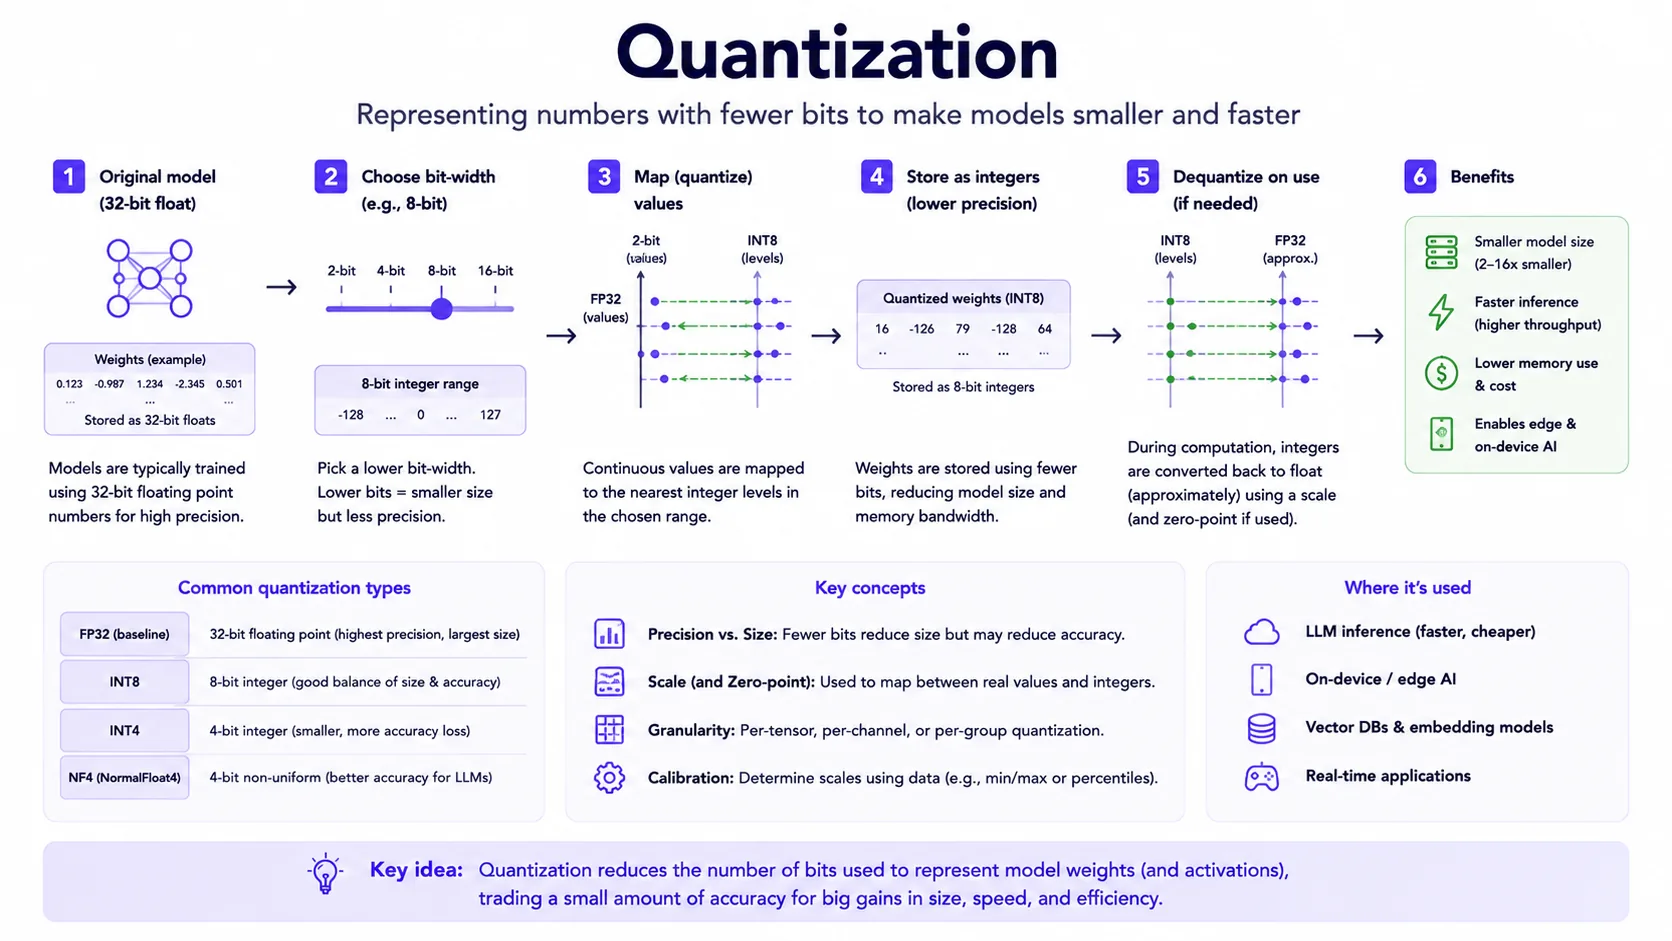
Kuantisasi mengurangi presisi bobot, activation, atau cache model, misalnya dari 16-bit menjadi 8-bit atau 4-bit. Ini dapat mengurangi penggunaan memory dan mungkin meningkatkan throughput ketika hardware, kernel, runtime, dan workload mendukung format yang dipilih; tetapi juga dapat menurunkan kualitas, kalibrasi, atau keandalan tool call.
LoRA dan Fine-Tuning
LoRA biasanya membekukan base model lalu melatih parameter low-rank adapter, sehingga mengurangi jumlah parameter yang perlu dilatih dan sering kali kebutuhan memory dibanding full fine-tuning. Pendekatan ini berguna untuk adaptasi perilaku, gaya, format, atau tugas/domain, tetapi bukan pengganti retrieval yang andal jika fakta sering berubah; adaptasi pengetahuan tetap bergantung pada data, setup training, dan evaluasi.
Beranjak dari optimasi model ke preference tuning, observabilitas, evaluasi, keamanan, routing, dan kontrol biaya.
Direct Preference Optimization (DPO) dan reinforcement learning from human feedback (RLHF)
RLHF dan DPO mengoptimalkan perilaku model menggunakan data manusia atau data preferensi. RLHF biasanya melibatkan reward modeling dan policy optimization. DPO mengoptimalkan preferensi secara langsung dengan objective yang lebih sederhana. Keduanya bergantung pada kualitas preferensi dan dapat overfit pada hal-hal yang diberi reward oleh rater.
LLM Observabilitas
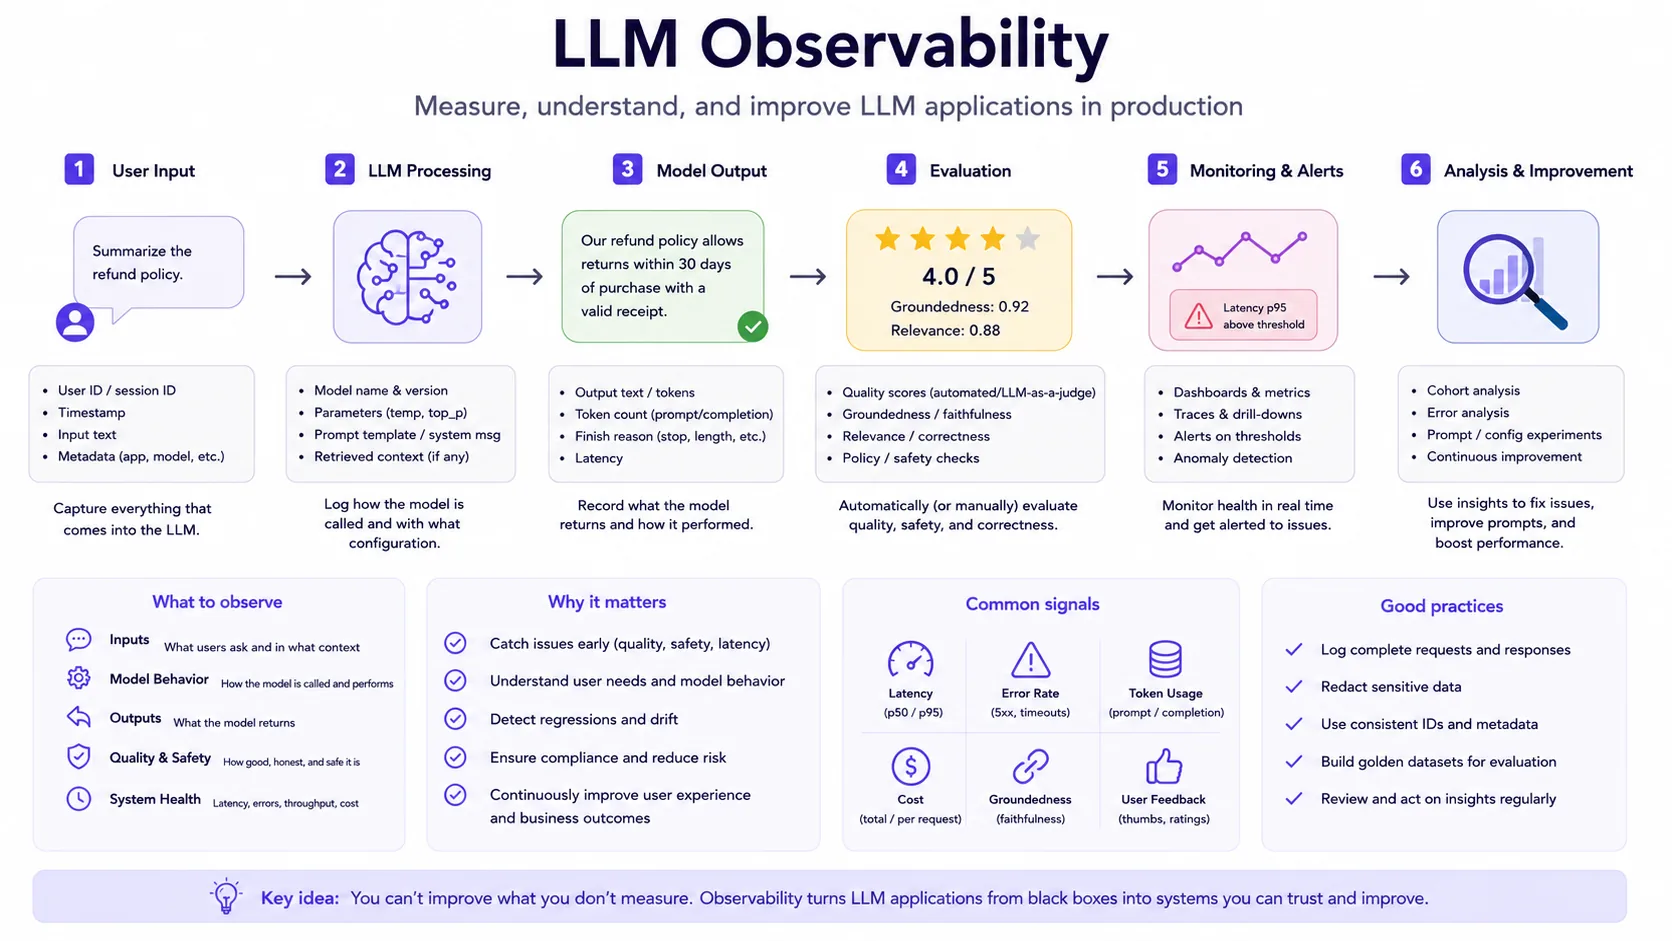
Observabilitas LLM melacak prompt, hasil retrieval, tool call, latensi, biaya, feedback pengguna, kejadian keamanan, dan skor evaluasi. Log harus memperhatikan privasi: rekam secukupnya untuk debugging, tetapi hindari menyimpan data sensitif yang tidak diperlukan.
Evaluasi Retrieval-Augmented Generation (RAG)
Evaluasi RAG memisahkan kualitas retrieval dari kualitas jawaban. Ukur apakah dokumen yang tepat ditemukan, apakah jawaban menggunakan dokumen tersebut, apakah citation mendukung klaim, dan apakah output akhir memenuhi tugas.
Untuk contoh konkret evaluasi respons di luar stack produksi, lihat Tes Kualitas Respons, tempat prompt yang sama dibandingkan pada empat asisten.
Model Routing
Model routing mengirim setiap tugas ke model atau alur kerja termurah yang masih memadai. Klasifikasi sederhana mungkin menggunakan model kecil; reasoning kompleks mungkin membutuhkan model yang lebih kuat; jawaban berisiko mungkin memerlukan retrieval dan review. Routing hanya menghemat biaya jika kontrol kualitas dapat menangkap salah rute.
AI Safety Red Teaming
Red teaming menguji bagaimana sistem gagal ketika menghadapi input adversarial atau tidak biasa. Untuk aplikasi LLM, uji prompt injection, kebocoran data, penggunaan tool yang tidak aman, bypass kebijakan, instruksi tersembunyi, dan prompt social engineering. Tujuannya adalah memperbaiki kontrol, bukan membuktikan sistem sempurna.
Optimasi Biaya untuk Aplikasi Large Language Model (LLM)
Optimasi biaya menggabungkan kompresi prompt, caching, routing, batching, context pruning, kualitas retrieval, kuantisasi, dan evaluasi. Optimalkan biaya per tugas yang berhasil, bukan hanya biaya per token. Model murah yang membutuhkan tiga retry dapat lebih mahal daripada sekali memakai model yang lebih kuat.