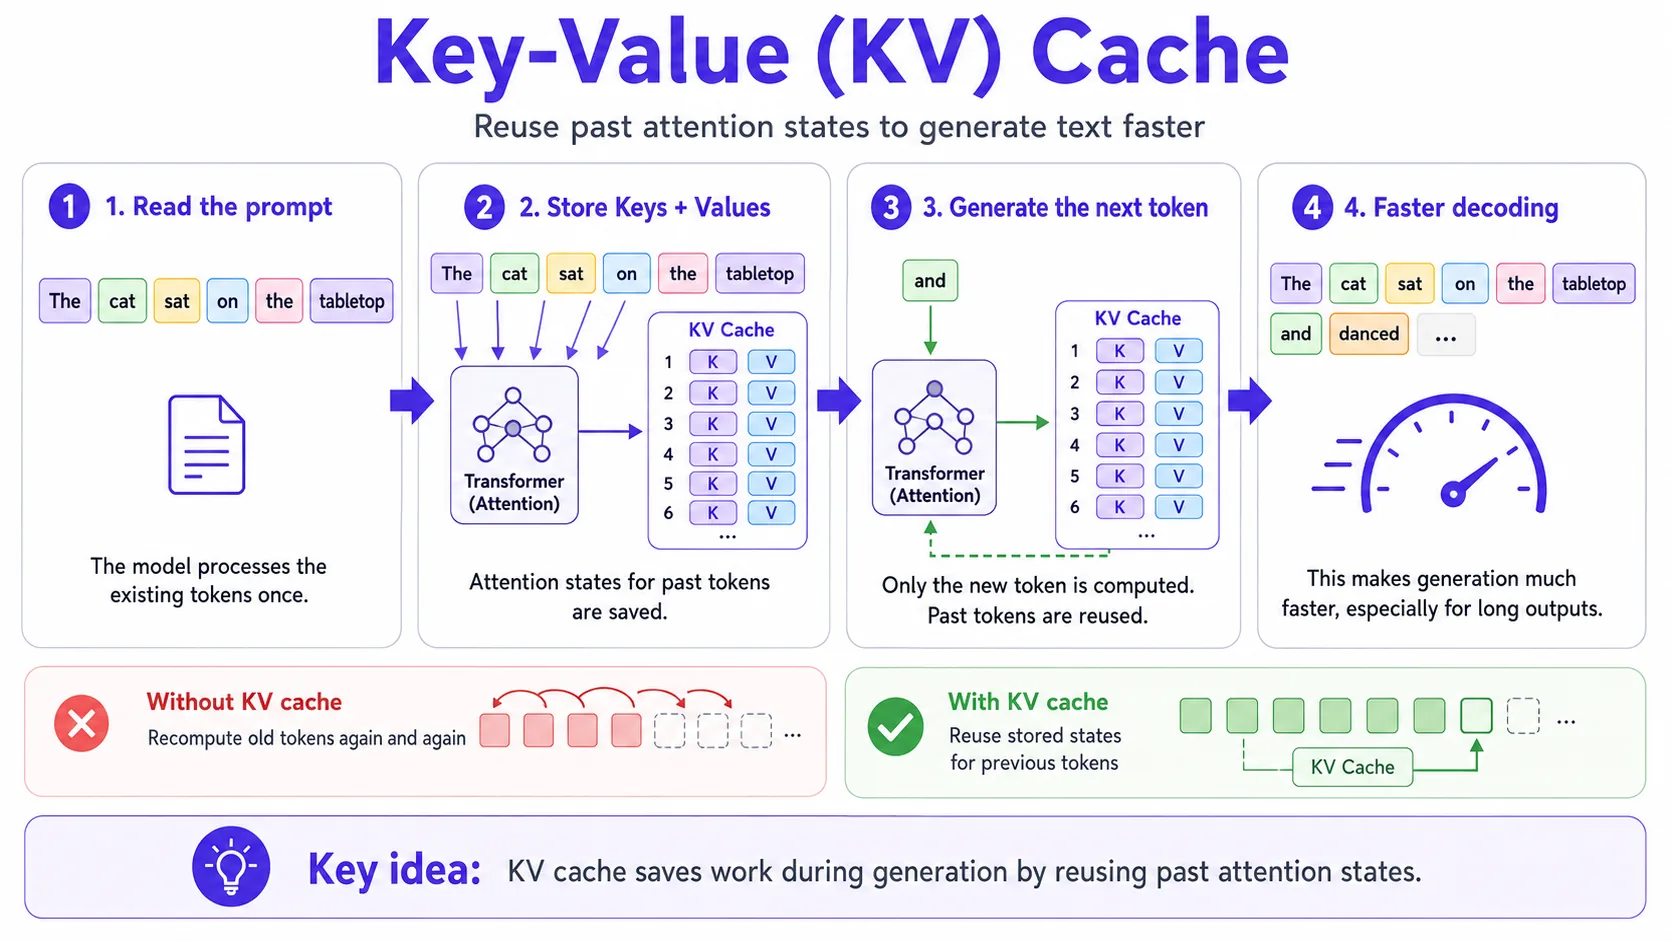
Key-Value (KV) Cache
Iniimbak ng KV caching ang mga key-value tensor mula sa mga naunang token habang autoregressive na bumubuo ng teksto. Sa halip na muling kalkulahin ang buong prefix para sa bawat bagong token, ginagamit ulit ng model ang mga naka-cache na representation. Pinapababa nito ang latency sa mahahabang output, ngunit pinapataas ang pangangailangan sa memory para sa bawat aktibong request.
Ang production control plane para sa mga LLM application
Sa expert level, hindi lang paghahanap ng iisang perpektong model ang mahalaga sa LLM system, kundi pati routing, caching, evaluation, safety checks at feedback loops. Tinutukoy ng maaasahang platform kung aling model ang tatawagin, aling context ang kukunin, kailan gagamit ng mas murang model, kailan kailangang mag-escalate at paano matutukoy ang mga regression.
Pinag-iisa ang format ng mga request, nagpapatupad ng rate limits, nagdaragdag ng tenant metadata at pumipili ng mga posibleng model.
Pumipili ng maliit, malaki o espesyalisadong model batay sa hirap ng gawain, latency budget at panganib.
Sinusukat ang kalidad ng retrieval, kalidad ng sagot, katapatan ng mga citation sa pinagmulan, kaligtasan at validity ng schema.
Sinusubaybayan ang mga prompt, nakuhang content chunks, model versions, bilang ng token, latency percentiles at mga uri ng pagkabigo.
Mixture of Experts
Dinadaan ng Mixture of Experts ang mga token o halimbawa sa isang subset ng mga espesyalisadong expert network. Maaari nitong dagdagan ang parameter count nang hindi ginagamit ang lahat ng parameter para sa bawat token. Kapalit nito ang mas komplikadong routing, load balancing, communication overhead at debugging.
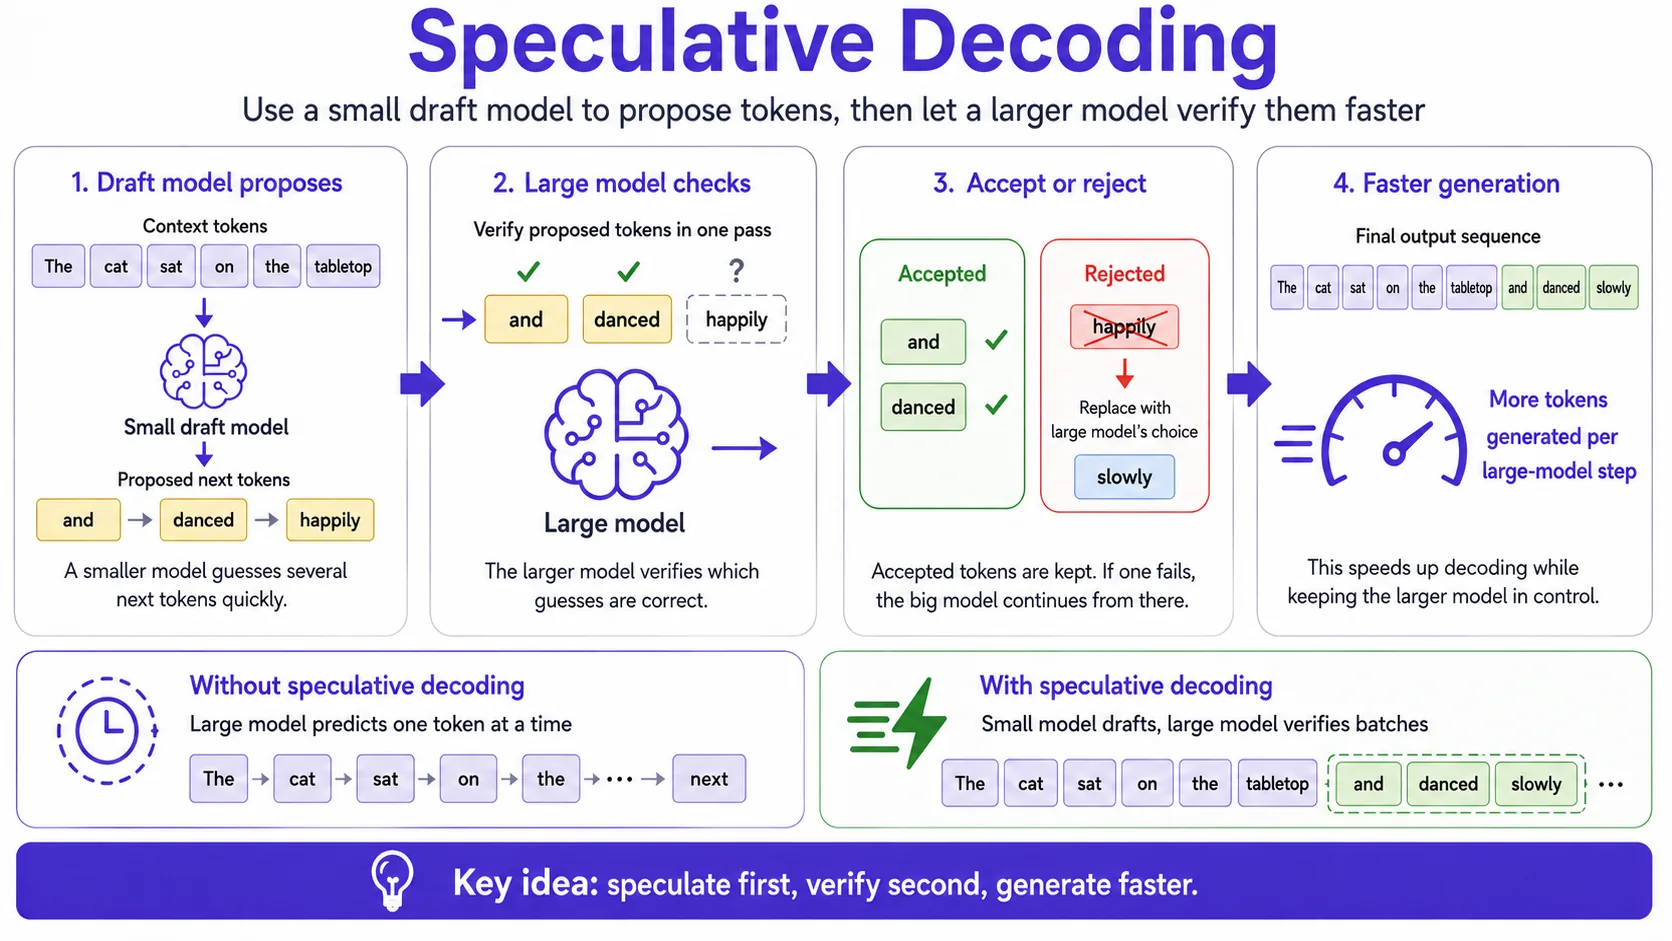
Speculative Decoding
Gumagamit ang speculative decoding ng draft model o draft procedure para magmungkahi ng mga token at target model para i-verify ang mga ito. Kayang mapanatili ng eksaktong speculative sampling algorithms ang output distribution ng target model; maaaring ipagpalit ng mga heuristic variant ang pagiging eksakto para sa bilis. Nakasalalay ang pagbilis sa acceptance rate, halaga ng draft, anyo ng sequence at batch, runtime at hardware.
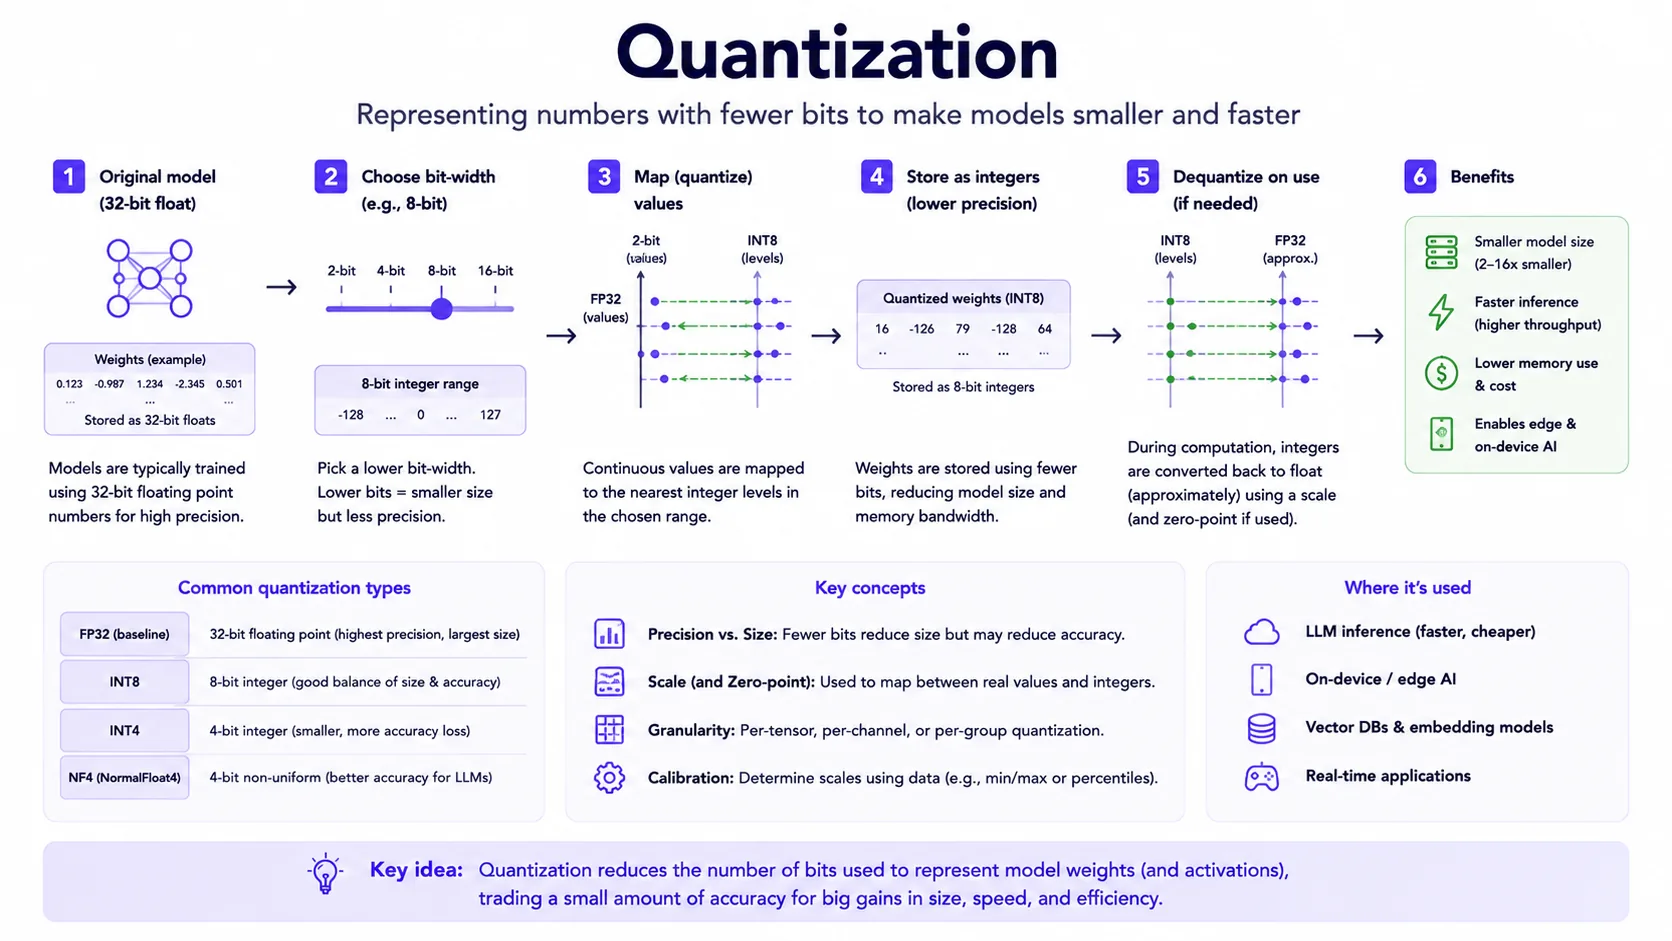
Quantization
Pinapababa ng quantization ang precision ng model weights, activations o caches, halimbawa mula 16-bit tungo sa 8-bit o 4-bit. Maaari nitong bawasan ang paggamit ng memory at pataasin ang throughput kung sinusuportahan ng hardware, kernels, runtime at workload ang napiling format. Maaari rin nitong pababain ang kalidad, calibration o pagiging maaasahan ng tool calls.
LoRA at Fine-Tuning
Karaniwang pini-freeze ng LoRA ang base model at sinasanay ang mga low-rank adapter parameter. Nababawasan nito ang bilang ng mga parameter na sinasanay at madalas pati ang kailangang memory kumpara sa full fine-tuning. Kapaki-pakinabang ito para baguhin ang behavior, style, format o pag-angkop sa gawain o domain, ngunit hindi ito maaasahang kapalit ng retrieval kung madalas nagbabago ang mga impormasyon. Nakasalalay pa rin sa datos, training setup at evaluation ang anumang pag-angkop ng kaalaman.
Mula sa pag-optimize ng model, magpatuloy sa preference tuning, observability, evaluation, safety, routing at pagkontrol ng gastos.
Direct Preference Optimization (DPO) at reinforcement learning from human feedback (RLHF)
Pinapahusay ng RLHF at DPO ang behavior ng model gamit ang datos mula sa tao o mga preference. Karaniwang may reward modeling at policy optimization sa RLHF. Direktang ino-optimize ng DPO ang mga preference gamit ang mas simpleng objective. Pareho silang nakasalalay sa kalidad ng mga preference at maaaring mag-overfit sa mga bagay na binibigyang-gantimpala ng mga tagasuri.
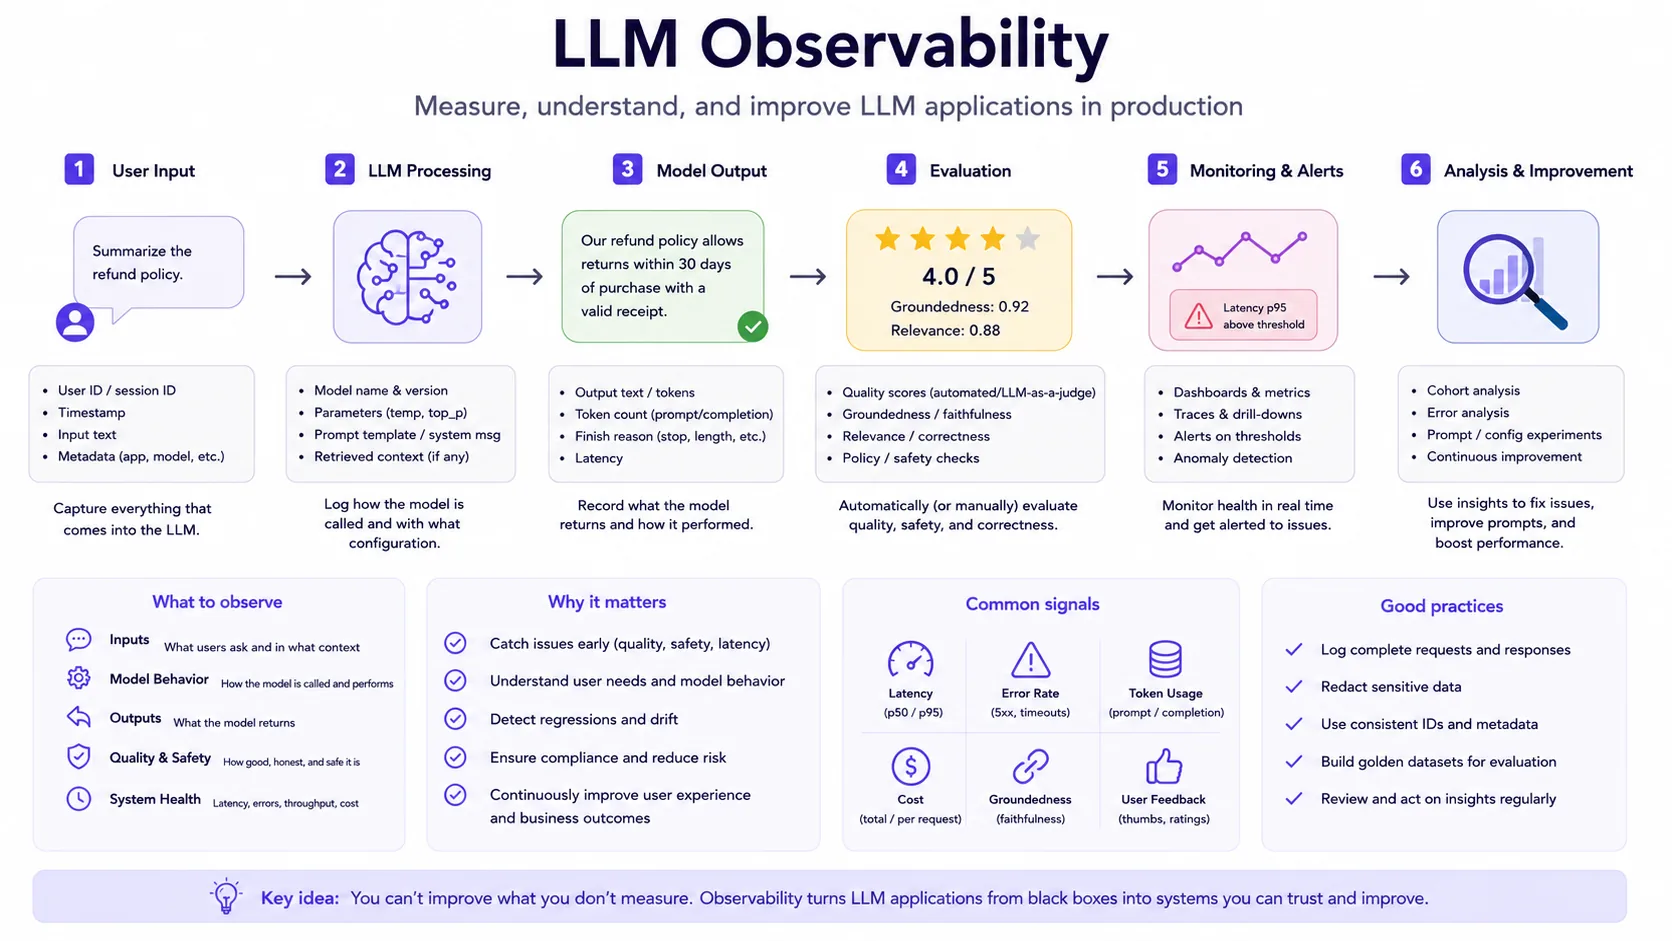
LLM Observability
Sinusubaybayan ng LLM observability ang mga prompt, resulta ng retrieval, tool calls, latency, gastos, feedback ng user, safety events at evaluation scores. Dapat isaalang-alang ang privacy sa mga log: kumuha ng sapat para sa debugging ngunit iwasang mag-imbak ng hindi kailangang sensitibong datos.
Pagsusuri ng Retrieval-Augmented Generation (RAG)
Magkahiwalay na sinusuri ng RAG evaluation ang kalidad ng retrieval at kalidad ng sagot. Sukatin kung natagpuan ang mga tamang dokumento, kung nagamit ang mga ito sa sagot, kung sinusuportahan ng mga citation ang mga claim at kung natutugunan ng huling output ang gawain.
Para sa kongkretong halimbawa ng pagsusuri ng sagot sa labas ng production stack, tingnan ang Response Quality Tests, kung saan inihahambing ang parehong mga prompt sa apat na AI assistant.
Model Routing
Ipinapadala ng model routing ang bawat gawain sa pinakamurang model o workflow na sapat ang kakayahan. Maaaring gumamit ng maliit na model para sa simpleng pag-uuri, mas mahusay na model para sa komplikadong reasoning, at retrieval at review para sa mapanganib na sagot. Makakatipid lang ang routing kung nasasalo ng quality controls ang maling pagpili ng model.
AI Safety Red Teaming
Sinusubok ng red teaming kung paano pumapalya ang mga system sa mapanlinlang o hindi pangkaraniwang input. Para sa LLM apps, subukan ang prompt injection, data leakage, hindi ligtas na paggamit ng tool, pag-iwas sa policy, mga nakatagong tagubilin at social-engineering prompts. Layunin nitong pagbutihin ang mga kontrol, hindi patunayang perpekto ang system.
Pag-optimize ng Gastos para sa mga Large Language Model (LLM) App
Pinagsasama ng cost optimization ang prompt compression, caching, routing, batching, context pruning, kalidad ng retrieval, quantization at evaluation. I-optimize ang gastos bawat matagumpay na gawain, hindi lang bawat token. Maaaring mas mahal ang murang model na kailangan ng tatlong retry kaysa sa isang beses na paggamit ng mas mahusay na model.