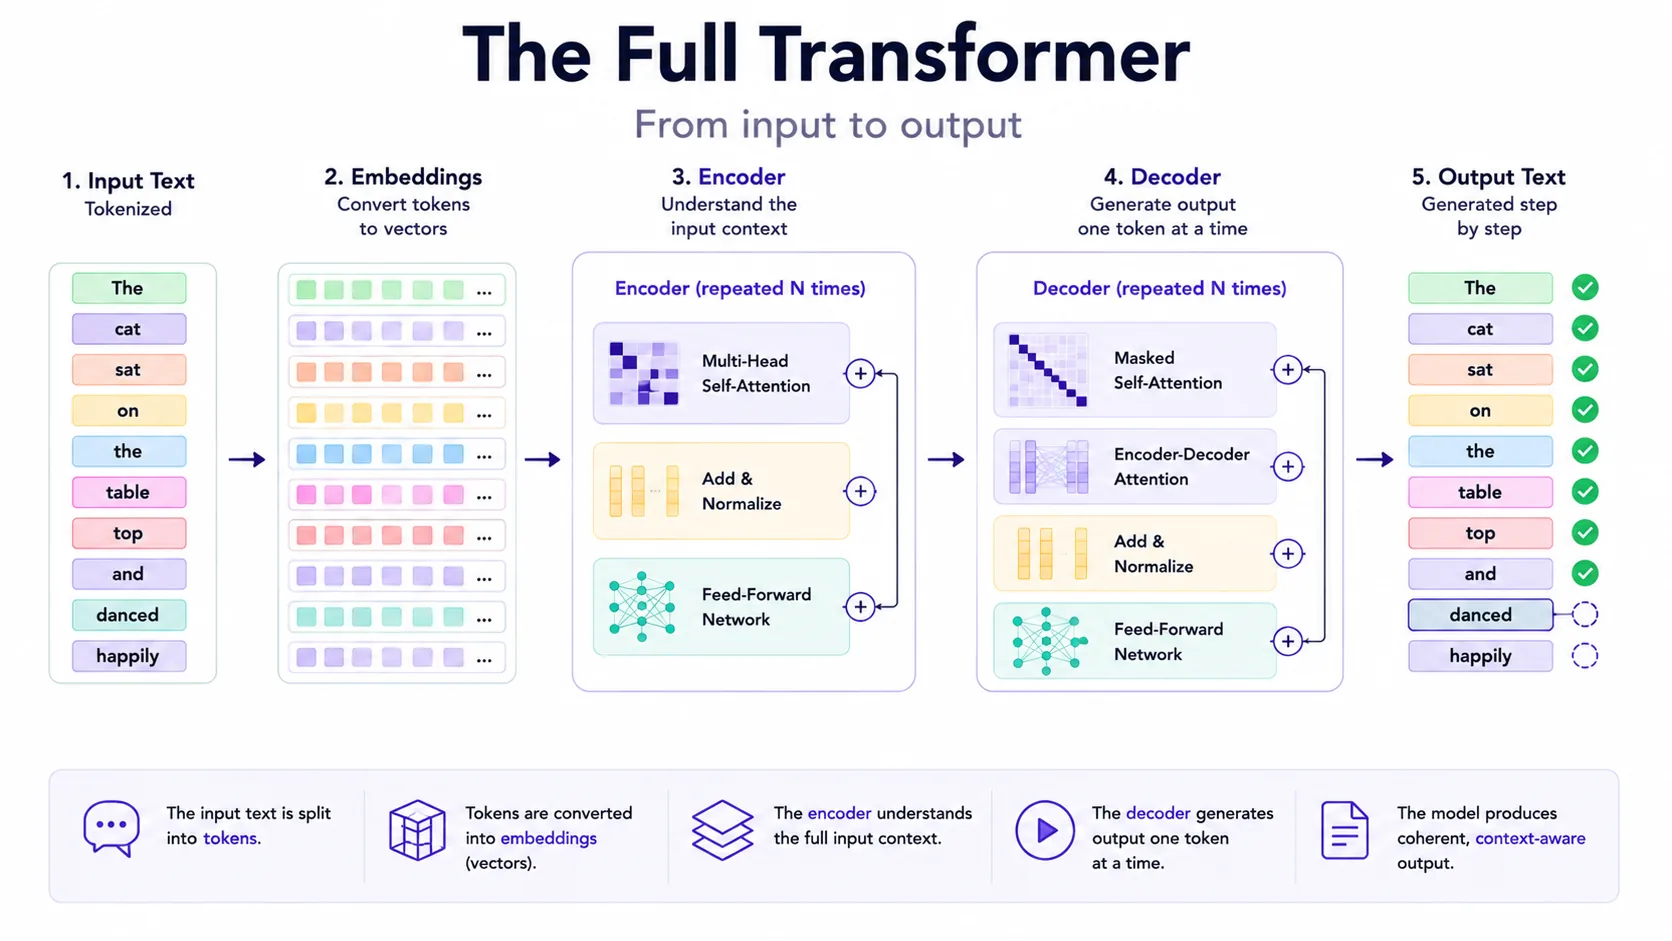
Paliwanag sa Transformer
Ang Transformer ang arkitekturang ginagamit sa maraming modernong LLM. Pangunahing ideya nito ang pagproseso ng mga token sa pamamagitan ng attention layers para matimbang ng model ang mga ugnayan sa buong context. Naging mas madaling iparallel ang training kumpara sa mas lumang recurrent approach, at naging pundasyon ito ng mga modernong language model.
Teknikal na daloy ng isang request
Karaniwang pipeline ang production LLM request, hindi isang model call lang. Bine-validate ng application ang input, binubuo ang prompt, kumukuha ng context kung kailangan, nagpapadala ng mga token sa model, opsyonal na tumatawag sa mga tool, sinusuri ang output at nagtatala ng traces para sa susunod na evaluation.
Pinagsasama ang system instructions, input ng user, memory, mga halimbawa at policy sa isang context na may malinaw na pagkakasunod-sunod.
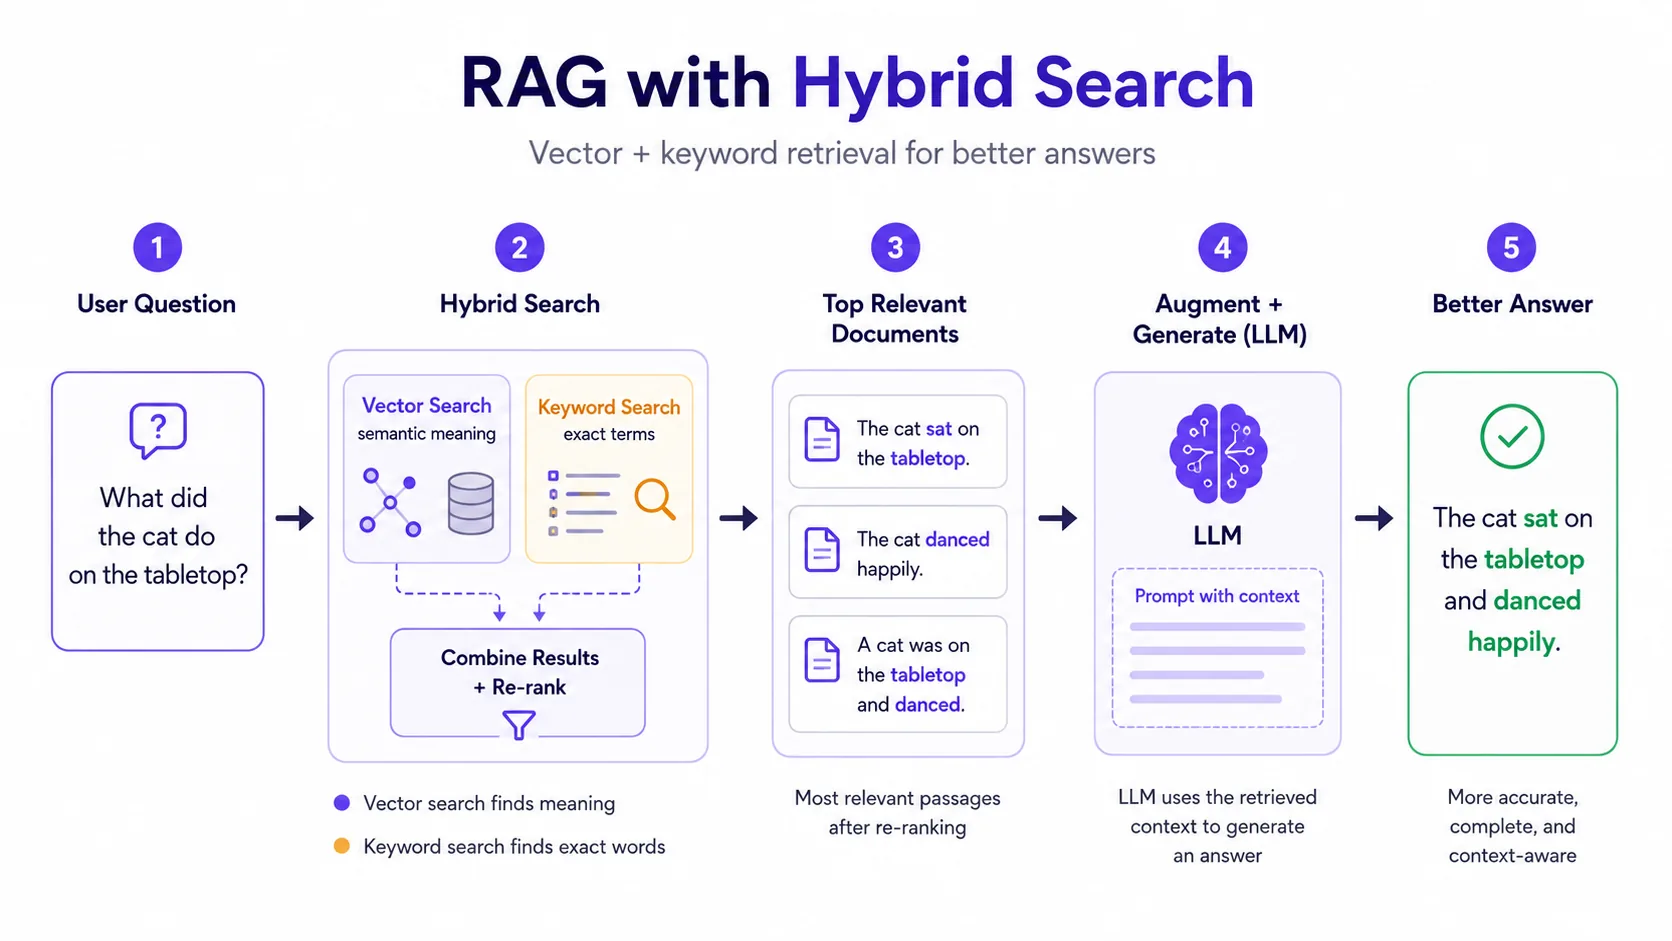
Opsyonal na hakbang na naghahanap ng mga nauugnay na bahagi sa vector database o keyword index. Ito ang sentro ng Retrieval-Augmented Generation (RAG).
Kinakalkula ng model ang mga probability ng susunod na token. Nakakaapekto ang mga setting ng decoding tulad ng temperature sa kung gaano kapare-pareho o kaiba-iba ang sagot.
Maaaring i-validate ng app ang mga citation, schema, pagsunod sa policy o output ng tool bago ipakita ang sagot sa user.
Paliwanag sa embeddings
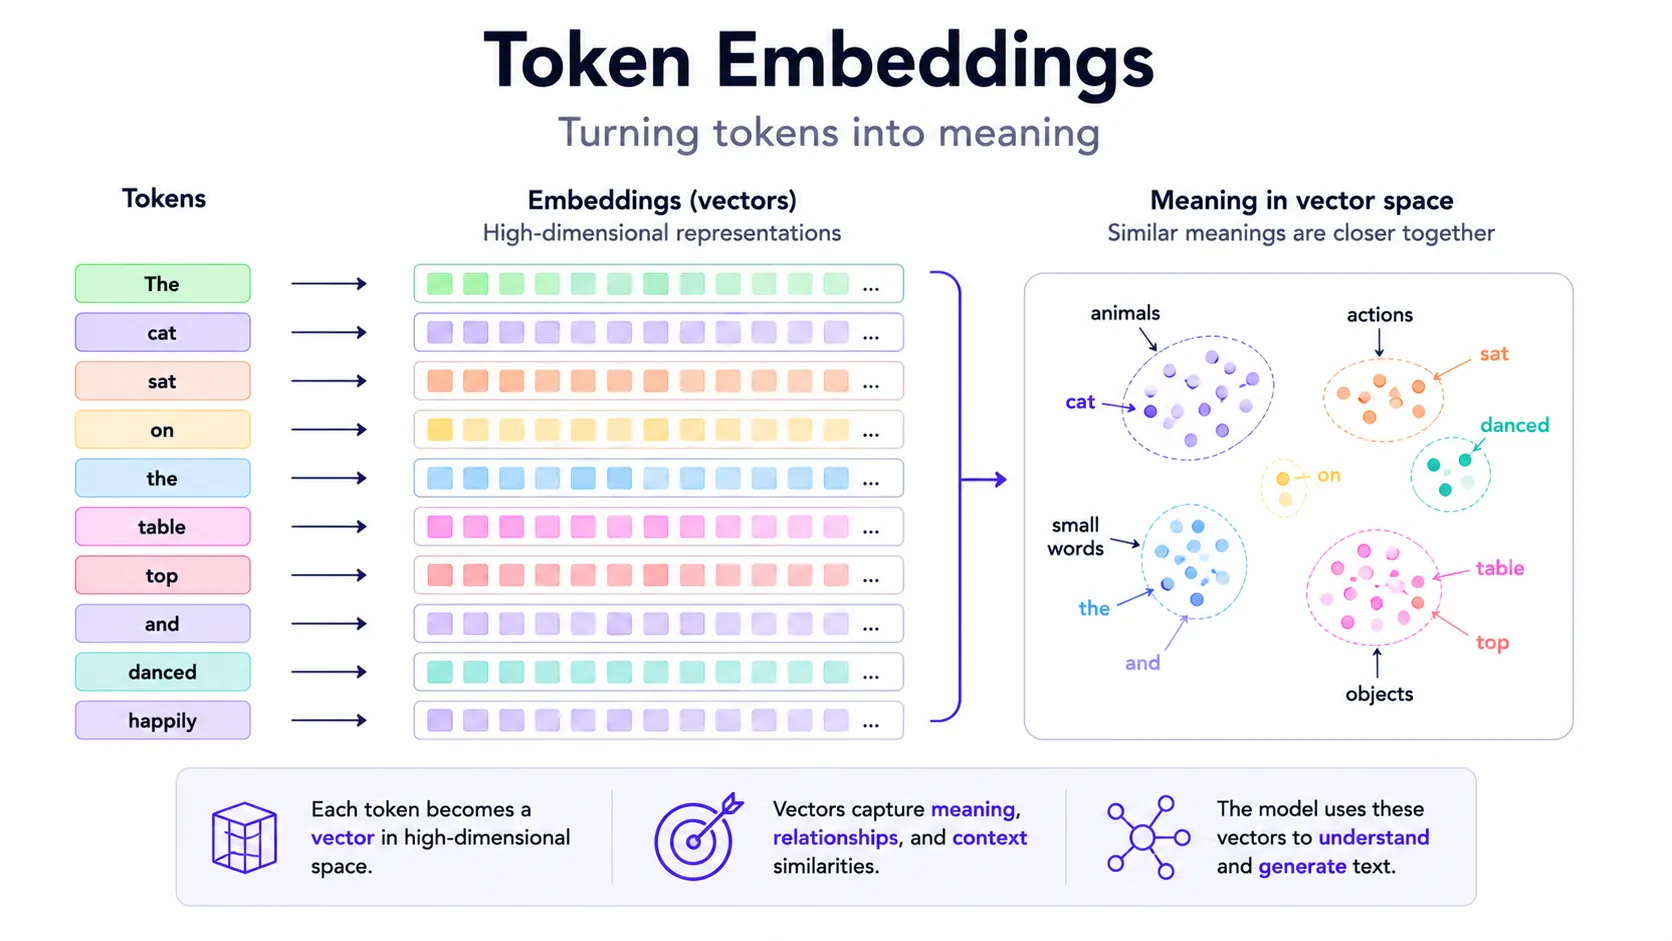
Ang embeddings ay mga numerong vector na kumakatawan sa teksto, larawan o iba pang data sa isang espasyo kung saan karaniwang mas magkalapit ang magkatulad na kahulugan. Kapaki-pakinabang ang mga ito para sa semantic search, clustering, rekomendasyon at retrieval. Mahalagang tandaan: hindi katotohanan ang embeddings; signal lamang ang mga ito ng pagkakatulad.
Paliwanag sa self-attention
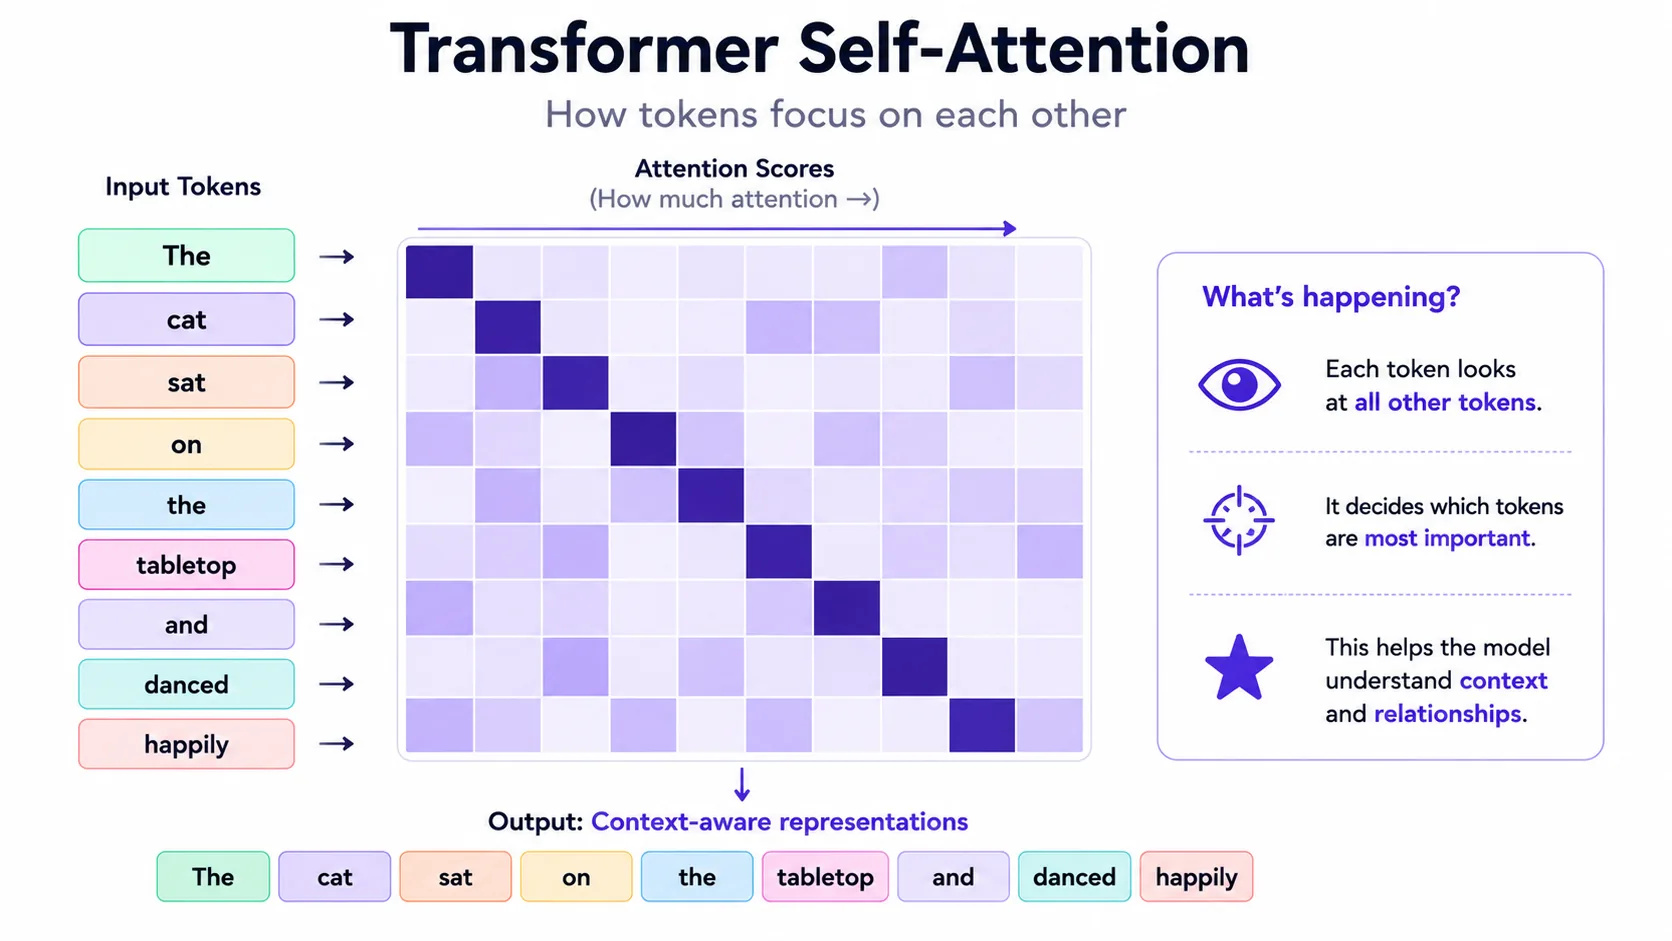
Sa self-attention, maaaring bigyang-timbang ng bawat token ang ibang mga token sa parehong context. Paulit-ulit na kinakalkula ng model ang mga ugnayan sa iba’t ibang layer, kaya nabubuo ang mas detalyadong representasyon ng mga salita, parirala at dependency. Isa ito sa mga dahilan kung bakit nagagamit ng mga LLM ang mahahabang tagubilin at halimbawa.
Mas malalim na paliwanag sa tokenization
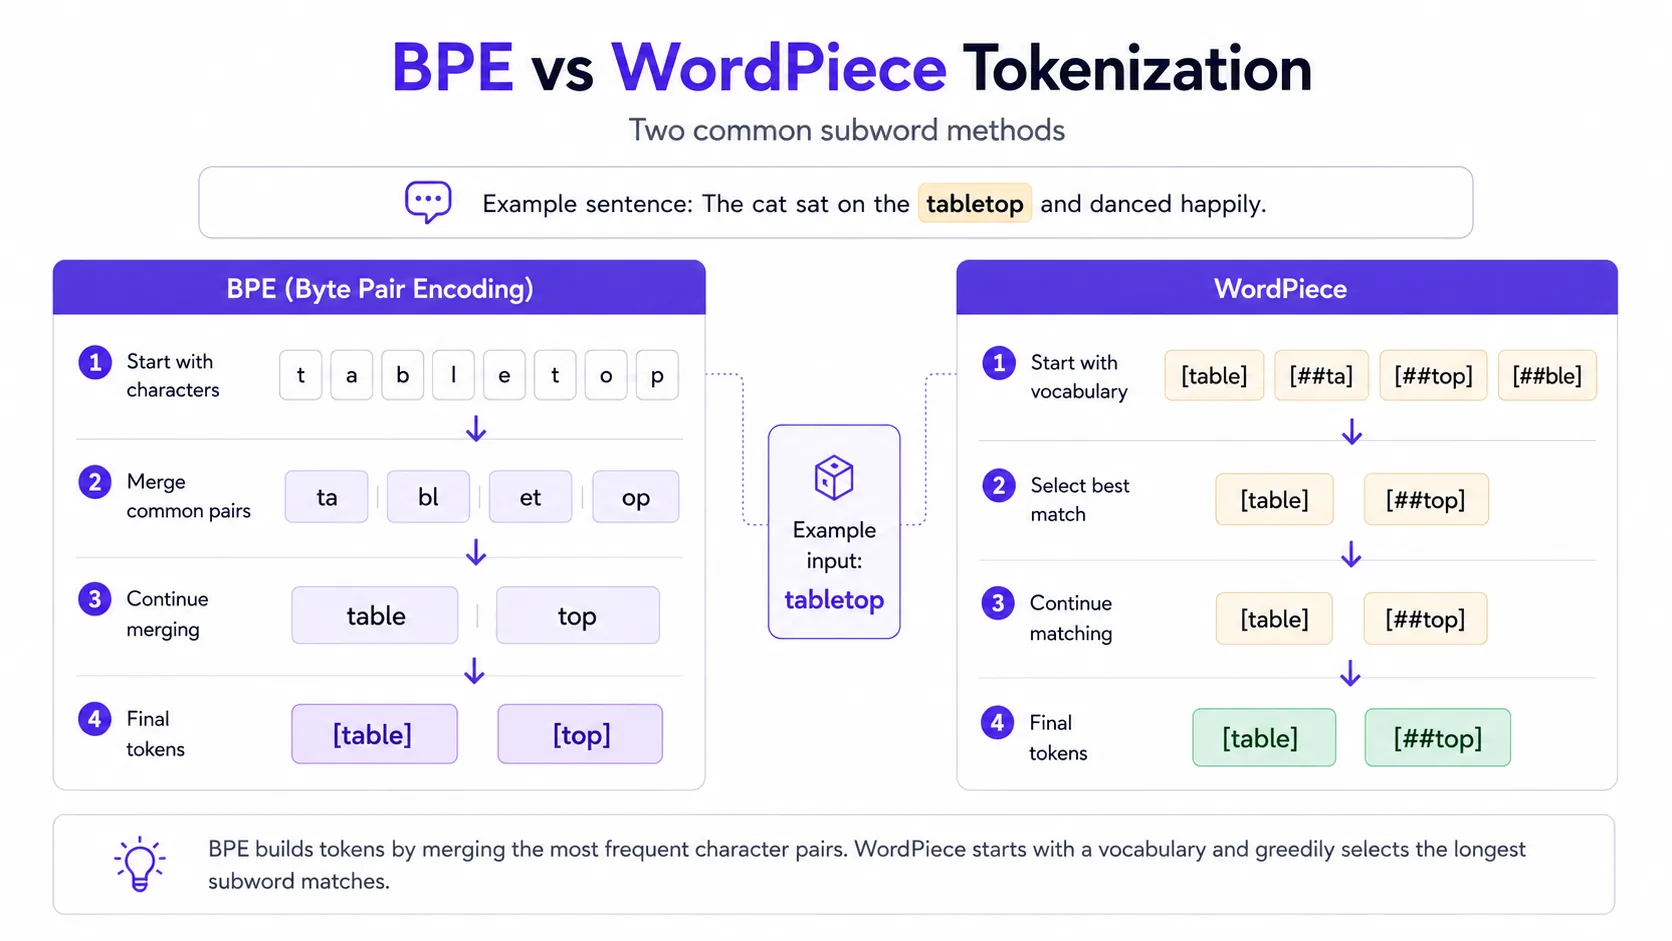
Ginagawang mga unit na nababasa ng model ang teksto sa pamamagitan ng tokenization. Maaaring magkaiba ang paghahati ng mga token sa iba’t ibang wika at sistema ng pagsulat, na nakakaapekto sa gastos at haba ng context. Ipinapaliwanag din nito kung bakit maaaring maging mahirap ang eksaktong character limits, code snippets at mga bihirang salita.
Arkitektura ng Retrieval-Augmented Generation (RAG)
Maaaring kabilang sa production RAG system ang ingestion, chunking, embeddings, index, retrieval, reranking, pagbuo ng prompt, paggawa ng sagot, citations at evaluation. Maraming pagkabigo ang nagsisimula bago pa bumuo ng sagot — halimbawa, hindi maayos na chunks, lumang dokumento, mahinang ranking o kulang na access filters. May iba pang pagkabigong nangyayari sa synthesis, citation, refusal o pagbuo mismo ng sagot.
Magpatuloy sa security, evaluation, mga tool, agent at mga control na kailangan sa tunay na application.
Prompt injection
Nangyayari ang prompt injection kapag sinusubukan ng hindi mapagkakatiwalaang teksto na palitan o lampasan ang mga tagubilin ng system o developer. Karaniwan ito sa RAG at agent workflow dahil maaaring may nakatagong tagubilin ang mga nakuhang web page. Ituring ang panlabas na content bilang data, hindi awtoridad.
Pagsusuri sa Large Language Model (LLM)
Sinusukat ng LLM evaluation kung tama, kapaki-pakinabang, ligtas at consistent ang mga output. Pagsamahin ang automated checks, rubrics na minamarkahan ng model, human review at mga test na partikular sa gawain. Subaybayan ang regression sa paglipas ng panahon, lalo na pagkatapos baguhin ang prompt, model o retrieval.
Function calling
Sa function calling, maaaring magbalik ang model ng structured arguments para sa isang tool sa halip na karaniwang teksto. Ang application ang magpapasya kung tatawagin ang tool, ibe-validate ang arguments at haharapin ang errors. Hindi dapat sa model lang nakasalalay ang security.
Paliwanag sa mga agent
Ang agent ay sistemang pinapatakbo ng LLM na makakaplano ng mga hakbang, makakatawag ng tool, makakakita ng mga resulta at makakapagpasya kung ano ang susunod — paulit-ulit hanggang makamit ang layunin o matugunan ang kondisyon para huminto. Hindi tulad ng isang prompt na nagbabalik lang ng isang sagot, umiikot ang agent sa proseso: mag-isip, kumilos, obserbahan, ulitin. Napakalakas nito sa mga gawaing maraming hakbang, pero mas mahirap itong suriin, siguraduhing ligtas at gawing predictable kaysa sa isang request.
Karaniwang may apat na bahagi ang isang praktikal na agent: model na nagpaplano, mga tool na puwede nitong tawagin (search, code execution, API), memory o scratchpad para subaybayan ang progreso, at guardrails na nagsasabi kung aling aksiyon ang kailangan ng pahintulot ng tao. Hindi kailanman ang model mismo ang hangganan ng seguridad — ang nakapaligid na application ang nagva-validate sa bawat aksiyon bago ito isagawa.
Large Action Models (LAMs)
Ang “Large Action Model” (LAM) ay impormal na katawagan sa industriya, hindi iisang standardized na arkitektura o palaging hiwalay na uri ng model. Karaniwang tumutukoy ito sa model o bahagi ng agent na naka-optimize para pumili at magsagawa ng aksiyon — gaya ng pagtawag ng tool, paggamit ng interface o paggawa ng sunod-sunod na hakbang sa software — sa halip na paliwanag na teksto lang ang buuin.
Sa praktika, hindi consistent ang paggamit sa “LAM” at “LLM agent.” Isang kapaki-pakinabang na pagkakaiba ay ang agent ang buong sistema — model, mga tool, memory o state, policies, execution environment at mga hakbang sa pag-apruba — samantalang ang “LAM” ay maaaring tumukoy sa bahaging pumipili ng aksiyon. Maraming production system ang gumagamit ng LLM na may tool calling, state management at guardrails, sa halip na hiwalay at tiyak na LAM architecture.
Mga multi-agent system at tool protocol
Habang lumalaki ang mga gawain, madalas hinahati ang isang agent sa ilang dalubhasang agent na nagtutulungan: may nagpaplano, kumukuha ng context, nagsasagawa at sumusuri ng resulta bago maaprubahan ang anumang aksiyon. Katulad ito ng paghahati ng trabaho ng maliit na team, at mas madaling subukan at pangasiwaan ang bawat bahagi kaysa sa iisang agent na sinusubukang gawin ang lahat.
May mga bukas na protocol na umuusbong para sa iba’t ibang antas ng integration. Itinatakda ng Model Context Protocol (MCP) ang client-server protocol para mailantad ang tools, resources at prompts sa mga AI application. Nakatuon naman ang Agent2Agent (A2A) protocol sa discovery, communication at paglilipat ng gawain sa pagitan ng mga agent. Puwedeng magsanib ang dalawa, pero iba-iba ang suporta, security profile at paggamit; opsiyon ang paggamit sa pareho, hindi pangkalahatang pamantayan para sa 2026.
Teknikal na paliwanag sa hallucination
Nagkakaroon ng hallucination dahil may pagitan ang maayos na pagbuo ng wika at ang beripikasyong nakabatay sa ebidensiya. Maaaring bumuo ang model ng kapani-paniwalang teksto kahit kulang sa batayan, mali ang pagbasa sa nakuhang context o sobra ang pag-generalize mula sa training patterns. Nangangailangan ang pag-iwas dito ng de-kalidad na retrieval, maingat na paghawak sa kawalan ng katiyakan, validation at evaluation — hindi lang mas magandang pagkakasulat ng prompt.