Penjelasan tentang Transformer
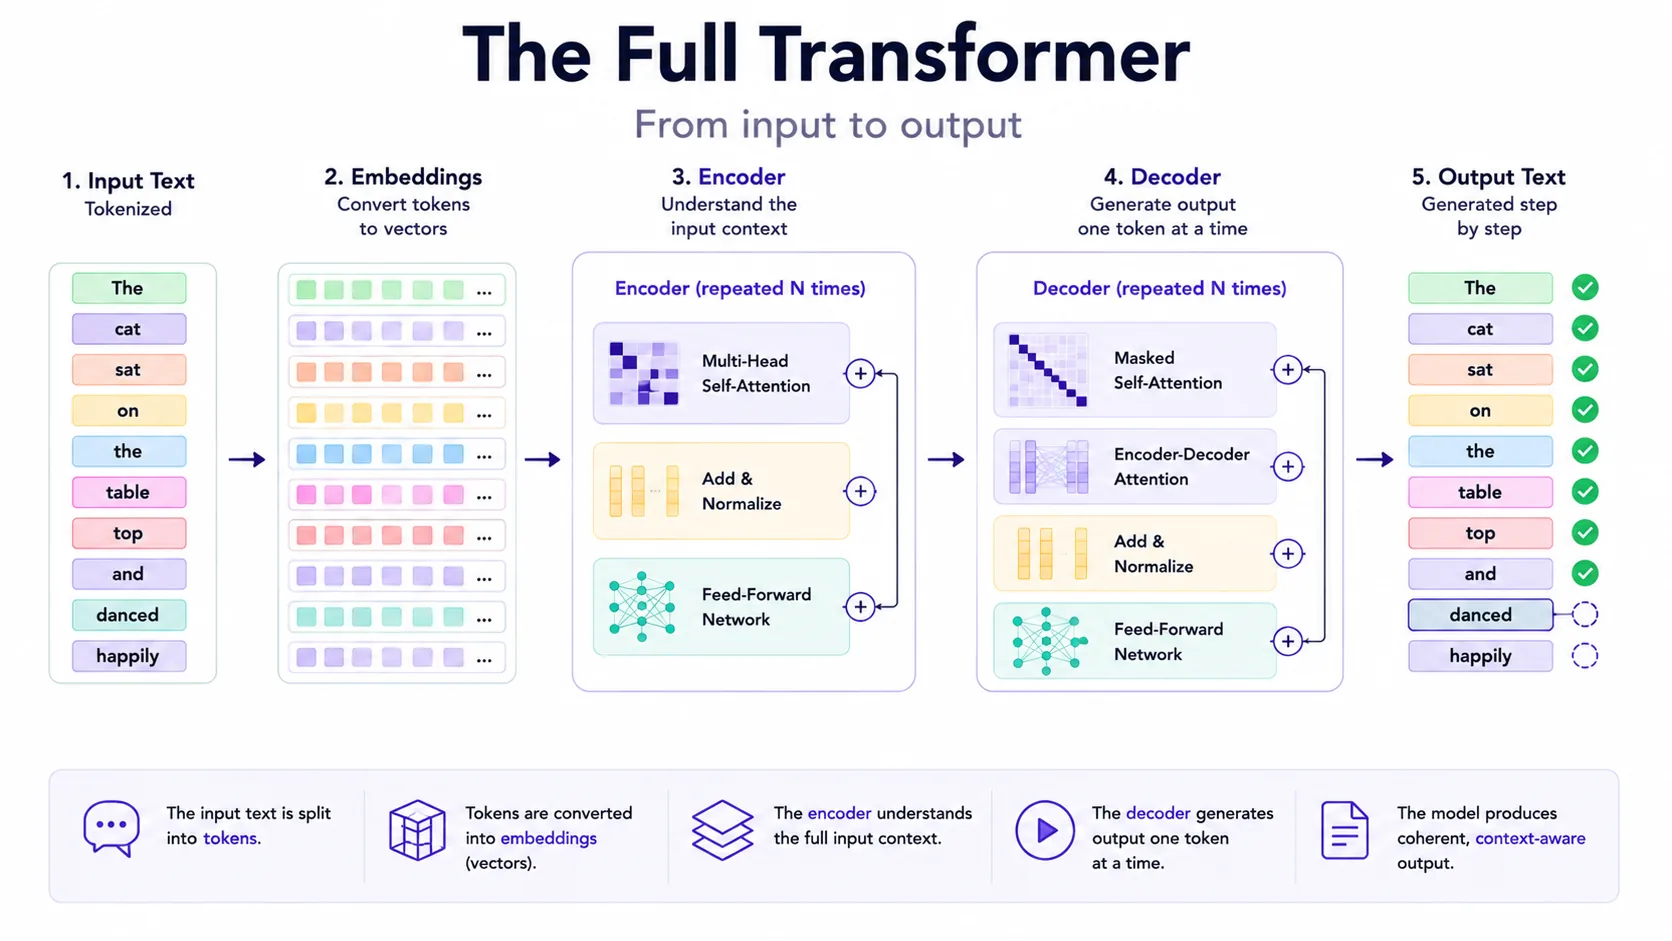
Transformer adalah arsitektur di balik banyak LLM modern. Gagasan utamanya adalah memproses token dengan lapisan attention agar model dapat memberi bobot pada hubungan di seluruh konteks. Pendekatan ini membuat training lebih mudah diparalelkan dibanding pendekatan recurrent yang lebih lama dan kemudian menjadi fondasi model bahasa modern.
Siklus teknis sebuah request
Request LLM di produksi biasanya berupa pipeline, bukan satu model call saja. Aplikasi memvalidasi input, menyusun prompt, mengambil konteks jika diperlukan, mengirim token ke model, secara opsional memanggil tool, memeriksa output, dan mencatat trace untuk evaluasi berikutnya.
Menggabungkan instruksi sistem, input pengguna, memory, contoh, dan kebijakan menjadi satu konteks yang terurut.
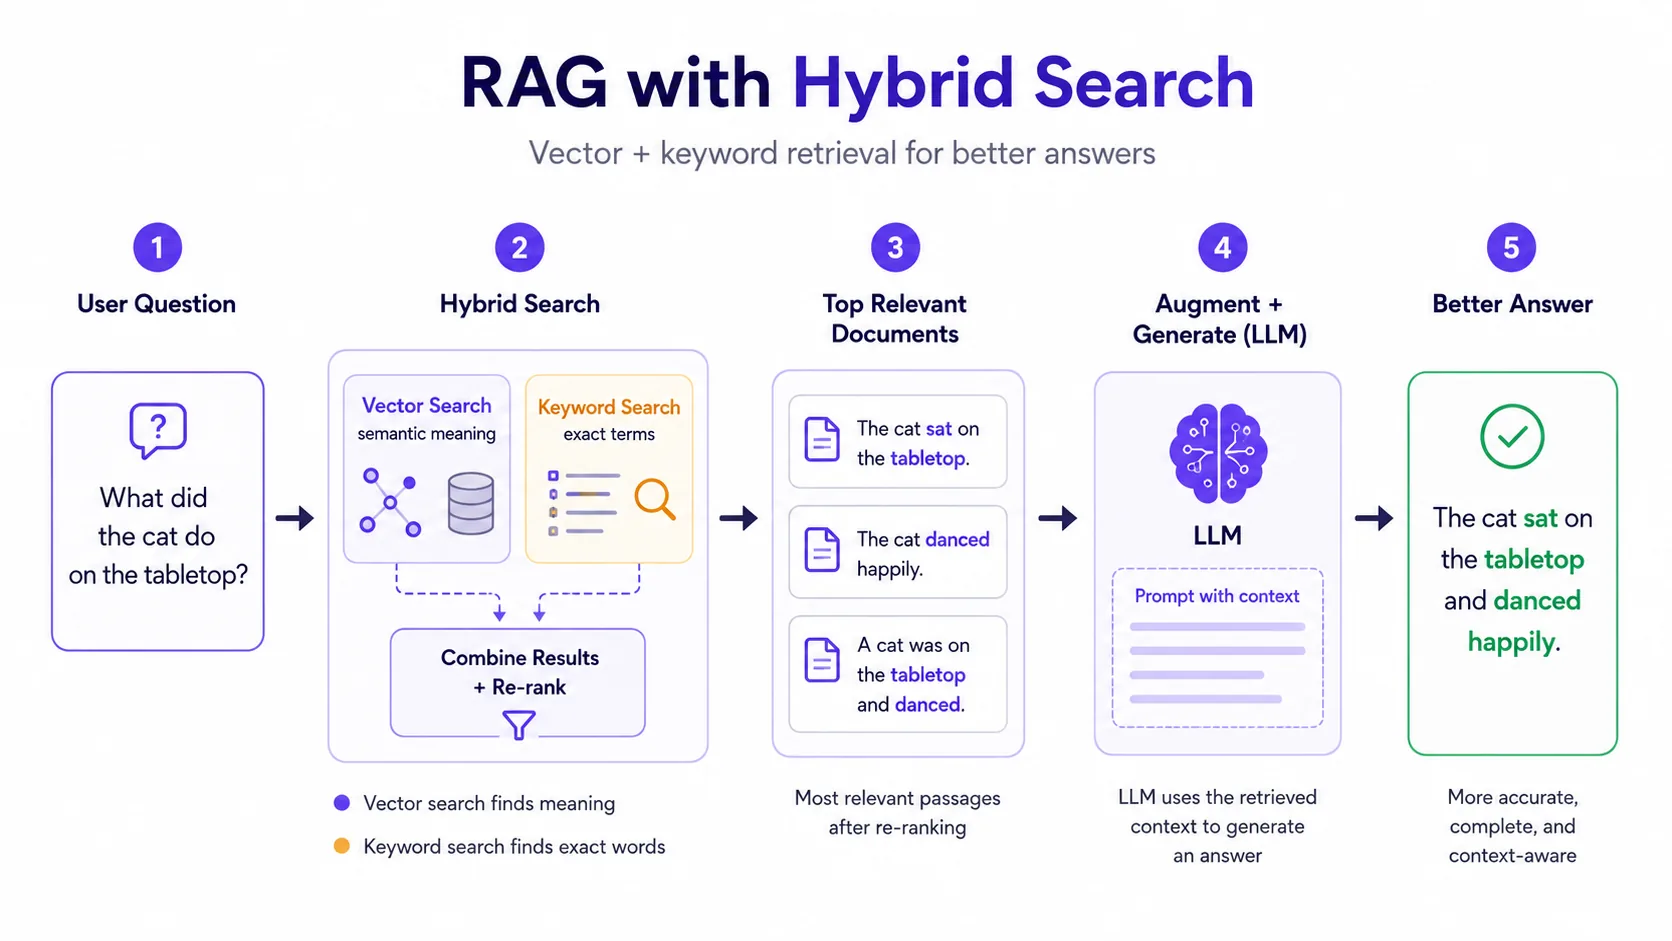
Langkah opsional yang mencari chunk relevan di vector database atau indeks keyword. Ini adalah inti Retrieval-Augmented Generation (RAG).
Model menghitung probabilitas token berikutnya. Pengaturan decoding seperti temperature memengaruhi seberapa deterministik atau bervariasi jawabannya.
Aplikasi dapat memvalidasi sitasi, skema, kepatuhan kebijakan, atau output tool sebelum menampilkan respons kepada pengguna.
Penjelasan tentang Embedding
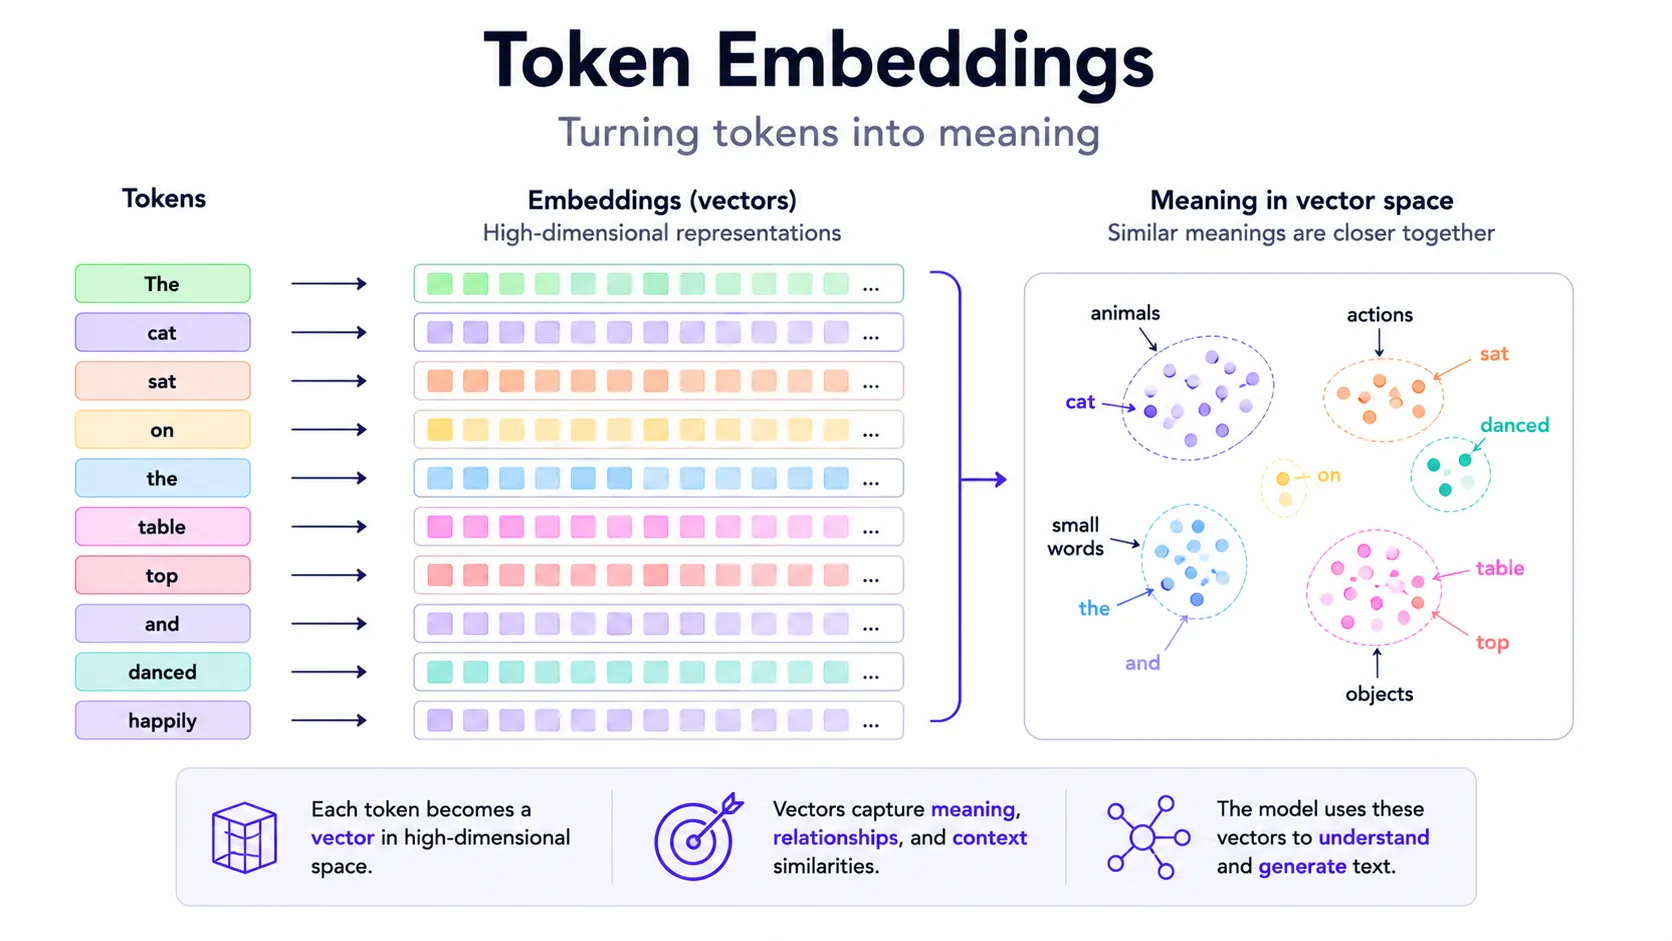
Embedding adalah vektor numerik yang merepresentasikan teks, gambar, atau data lain dalam ruang tempat makna yang mirip cenderung berada lebih dekat. Embedding berguna untuk semantic search, clustering, rekomendasi, dan retrieval. Hal pentingnya: embedding bukan kebenaran; embedding adalah sinyal kemiripan.
Penjelasan tentang Self-Attention
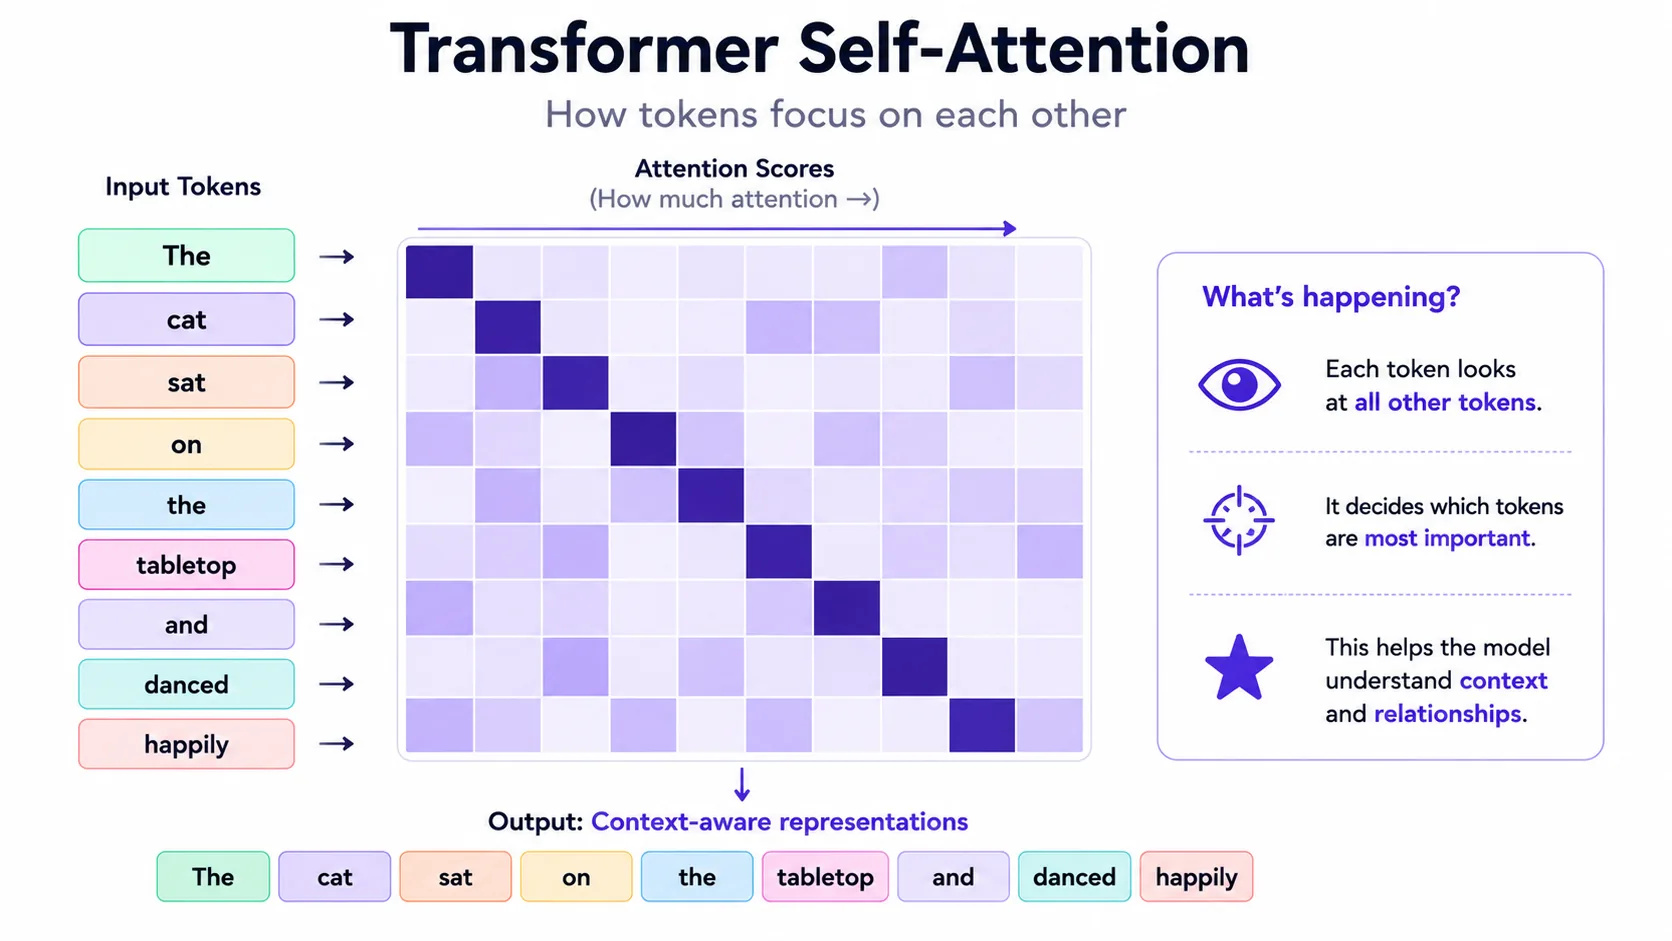
Self-attention memungkinkan setiap token memberi bobot pada token lain dalam konteks yang sama. Model menghitung hubungan ini berulang kali di berbagai lapisan sehingga menghasilkan representasi kata, frasa, dan dependensi yang lebih kaya. Ini adalah salah satu alasan LLM dapat menggunakan instruksi dan contoh yang panjang.
Pendalaman tokenisasi
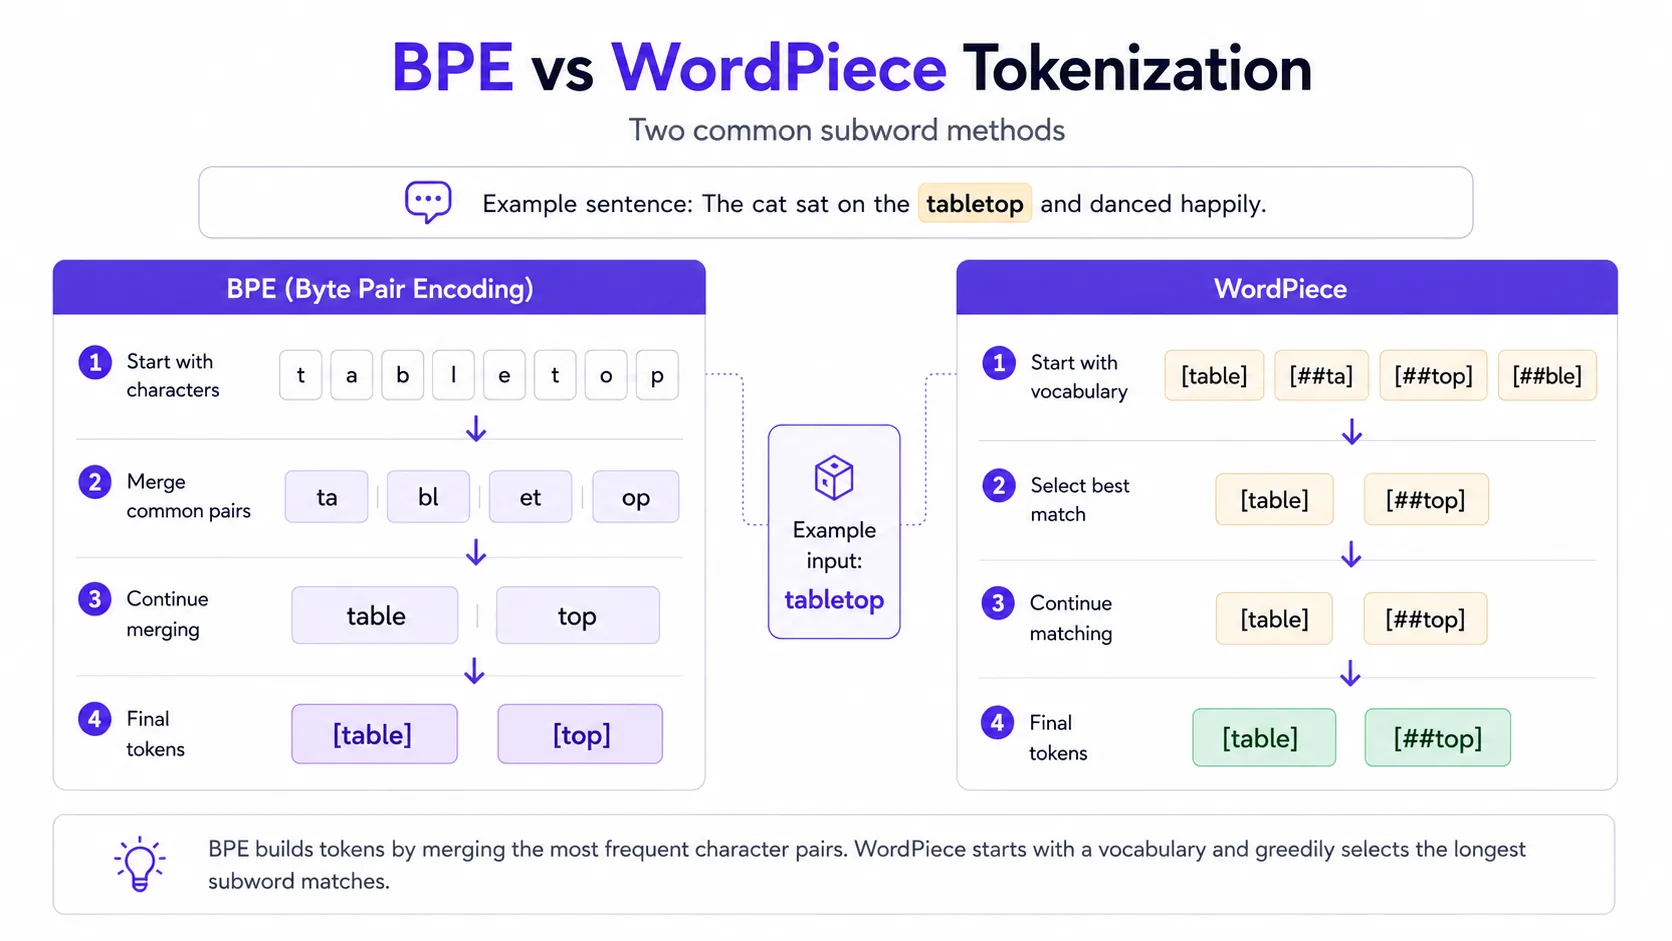
Tokenisasi mengubah teks menjadi unit yang dapat dibaca model. Bahasa dan sistem tulisan yang berbeda dapat menggunakan token secara berbeda, sehingga memengaruhi biaya dan panjang konteks. Tokenisasi juga menjelaskan mengapa batas karakter yang presisi, cuplikan kode, dan kata langka bisa lebih sulit ditangani.
Arsitektur Retrieval-Augmented Generation (RAG)
Sistem RAG di produksi dapat mencakup ingestion, chunking, embedding, index, retrieval, reranking, penyusunan prompt, generasi jawaban, sitasi, dan evaluasi. Banyak kegagalan berasal sebelum proses generasi — misalnya chunk yang buruk, dokumen usang, ranking lemah, atau filter akses yang hilang — sementara kegagalan lain muncul saat sintesis, sitasi, refusal, atau generasi jawaban.
Lanjutkan dengan keamanan, evaluasi, tool, agen, dan kontrol yang diperlukan di sekitar aplikasi nyata.
Prompt Injection
Prompt injection terjadi ketika teks yang tidak tepercaya mencoba menimpa instruksi sistem atau developer. Hal ini umum pada alur kerja RAG dan agen karena halaman hasil retrieval dapat berisi instruksi tersembunyi. Perlakukan konten eksternal sebagai data, bukan sebagai otoritas.
Evaluasi Large Language Model (LLM)
Evaluasi LLM mengukur apakah output benar, berguna, aman, dan konsisten. Gunakan kombinasi pemeriksaan otomatis, rubrik yang dinilai model, review manusia, dan tes khusus tugas. Pantau regresi dari waktu ke waktu, terutama setelah perubahan prompt, model, atau retrieval.
Function Calling
Function calling memungkinkan model mengembalikan argumen terstruktur untuk sebuah tool alih-alih teks bebas. Aplikasi kemudian memutuskan apakah tool dipanggil, memvalidasi argumen, dan menangani error. Model tidak boleh menjadi batas keamanan.
Penjelasan tentang Agen
Agen adalah sistem berbasis LLM yang dapat merencanakan langkah, memanggil tool, mengamati hasilnya, lalu memutuskan apa yang harus dilakukan berikutnya — berulang sampai tujuan tercapai atau kondisi berhenti terpenuhi. Berbeda dengan satu prompt yang mengembalikan satu jawaban, agen menjalankan siklus: menalar, bertindak, mengamati, mengulang. Ini membuat agen kuat untuk pekerjaan multi-langkah, tetapi juga lebih sulit dievaluasi, diamankan, dan dijaga agar tetap dapat diprediksi dibanding satu request.
Agen praktis biasanya menggabungkan empat bagian: model yang merencanakan, sekumpulan tool yang dapat dipanggil (pencarian, eksekusi kode, API), memory atau scratchpad untuk melacak progres, dan guardrail yang menentukan tindakan mana yang memerlukan persetujuan manusia. Model tidak pernah menjadi batas keamanan — aplikasi di sekelilingnya harus memvalidasi setiap tindakan sebelum dijalankan.
Large Action Models (LAM)
“Large Action Model” (LAM) adalah label informal di industri, bukan satu arsitektur standar atau kelas model terpisah yang disepakati secara universal. Istilah ini biasanya menggambarkan model atau komponen agen yang dioptimalkan untuk memilih dan menjalankan tindakan — seperti memanggil tool, mengoperasikan antarmuka, atau menghasilkan rangkaian langkah software — bukan hanya menghasilkan teks penjelasan.
Dalam praktiknya, “LAM” dan “LLM agent” digunakan secara tidak konsisten. Pembedaan konseptual yang berguna adalah bahwa agen merupakan keseluruhan sistem — model, tool, memory atau state, kebijakan, lingkungan eksekusi, dan langkah persetujuan — sedangkan “LAM” dapat merujuk ke komponen pemilih tindakannya. Banyak sistem produksi menerapkan tindakan menggunakan LLM plus tool calling, state management, dan guardrail, bukan arsitektur LAM terpisah.
Sistem multi-agen dan protokol tool
Seiring tugas membesar, satu agen sering dibagi menjadi beberapa agen khusus yang berkolaborasi: satu membuat rencana, satu mengambil konteks, satu mengeksekusi, dan satu memeriksa hasil sebelum apa pun disetujui. Ini meniru cara tim kecil membagi pekerjaan dan membuat setiap bagian lebih mudah diuji serta dikelola dibanding satu agen yang mencoba melakukan semuanya.
Protokol terbuka mulai bermunculan untuk lapisan integrasi yang berbeda. Model Context Protocol (MCP) mendefinisikan protokol client-server untuk mengekspos tool, resource, dan prompt ke aplikasi AI. Protokol Agent2Agent (A2A) berfokus pada discovery, komunikasi, dan handoff tugas antarsesama agen. Keduanya dapat saling melengkapi, tetapi dukungan, profil keamanan, dan tingkat adopsinya berbeda-beda; memakai keduanya adalah pilihan arsitektur, bukan standar universal pada 2026.
Halusinasi dijelaskan secara teknis
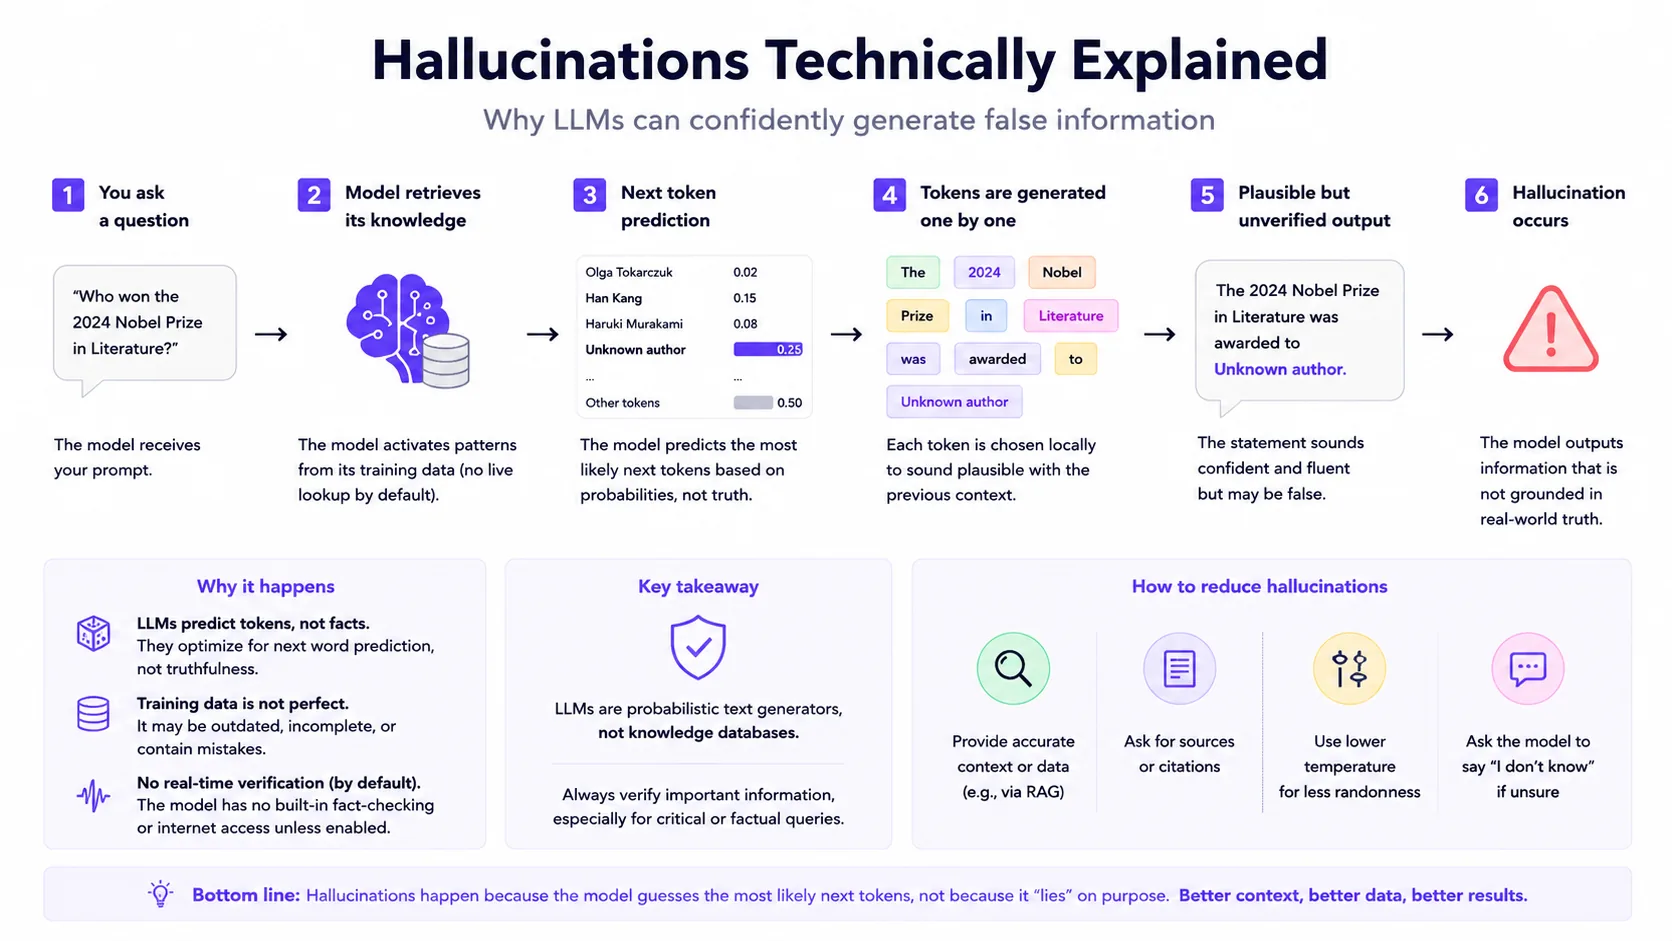
Halusinasi muncul dari kesenjangan antara generasi yang fasih dan verifikasi yang berlandaskan bukti. Model dapat menghasilkan teks yang tampak mungkin meskipun tidak memiliki bukti, salah membaca konteks hasil retrieval, atau melakukan generalisasi berlebihan dari pola training. Mitigasi membutuhkan kualitas retrieval, penanganan ketidakpastian, validasi, dan evaluasi — bukan hanya wording prompt yang lebih baik.