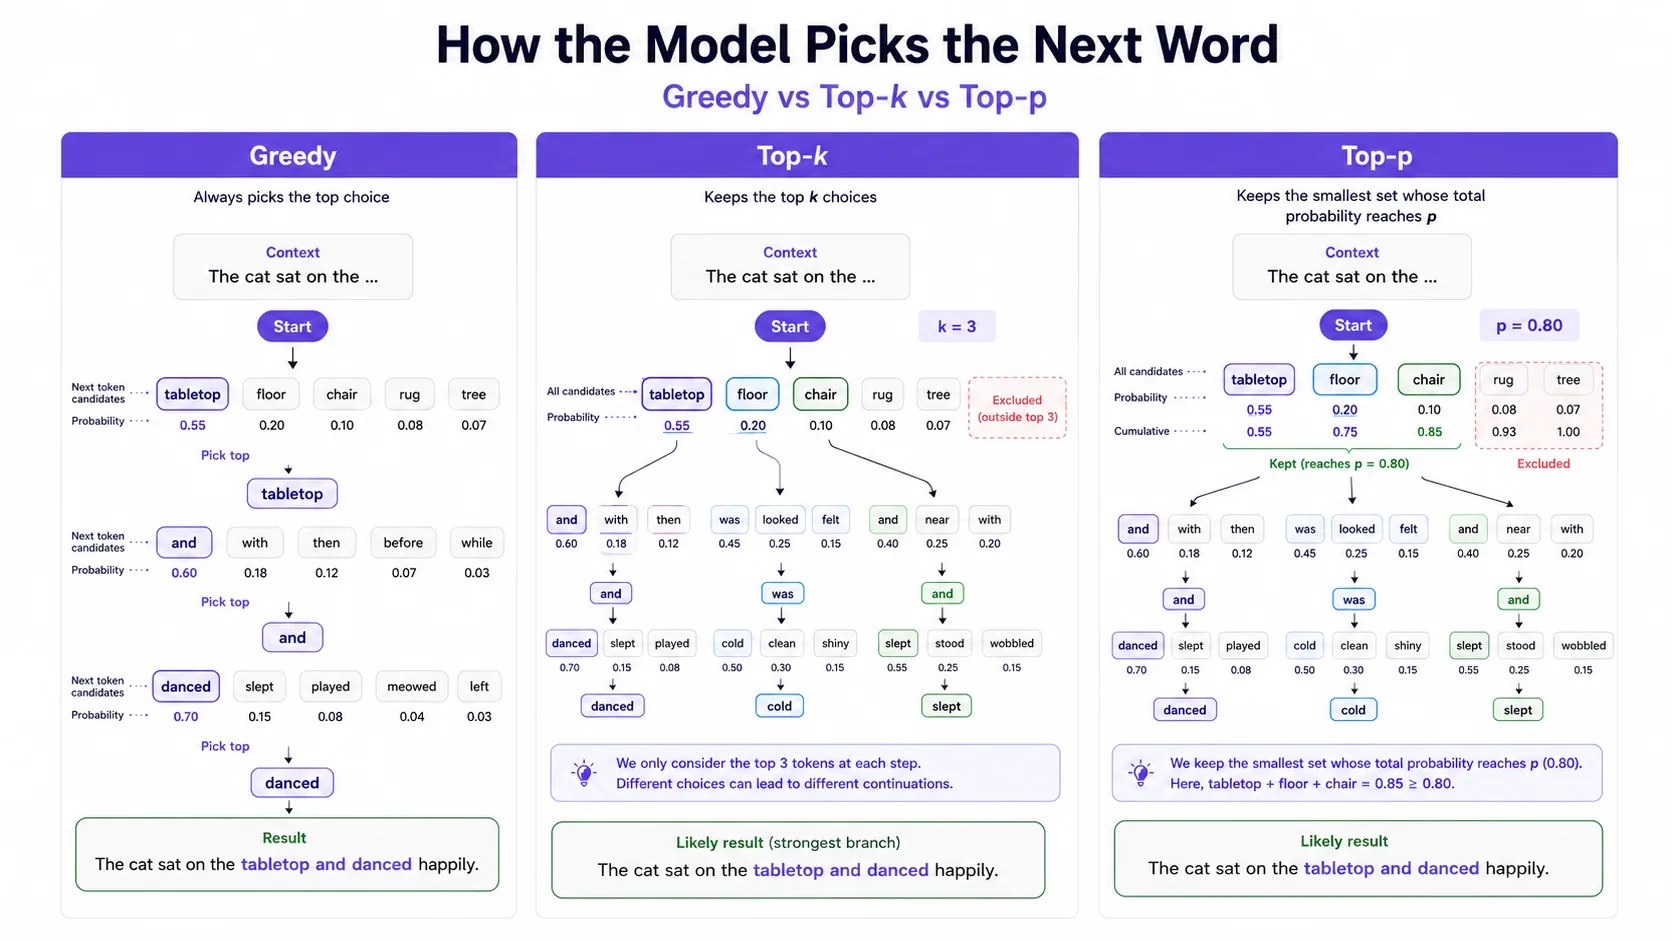
Penjelasan tentang Role Prompting
Role prompting meminta model menjawab dari perspektif profesional tertentu. Perannya harus relevan dengan tugas, bukan sekadar dramatis. “Bertindaklah sebagai manajer senior operasi dukungan” berguna untuk alur kerja tiket; “bertindaklah sebagai seorang genius” biasanya tidak banyak membantu.
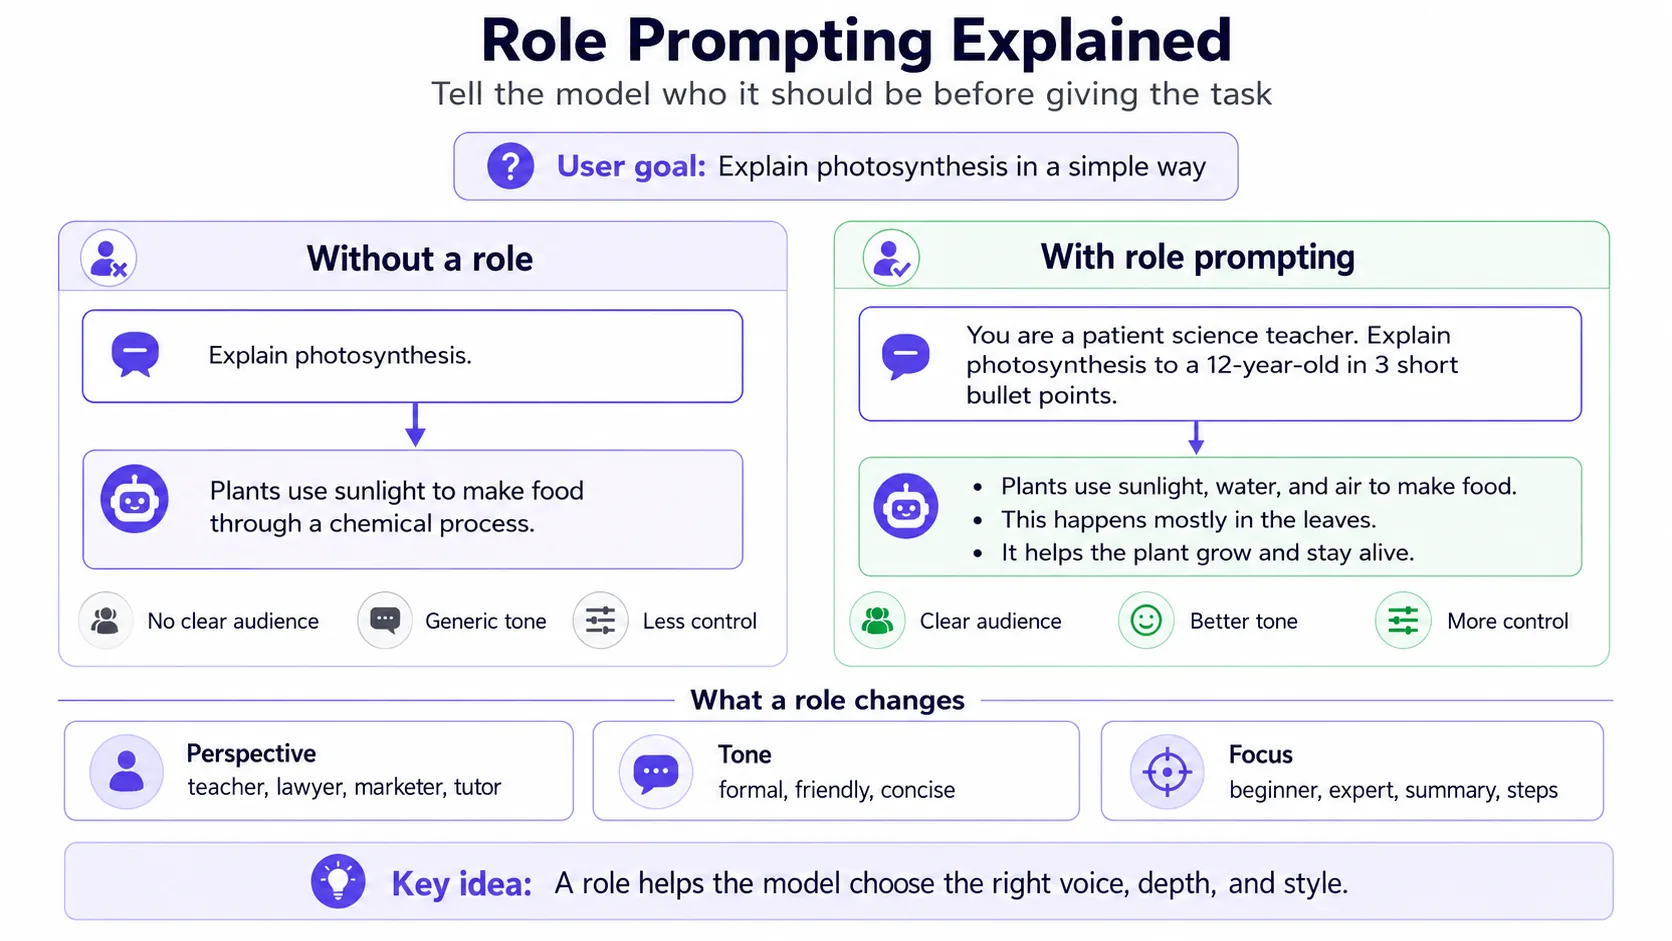
Penjelasan tentang Few-Shot Prompting
Few-shot prompting berarti Anda memberikan beberapa contoh input beserta output yang diinginkan. Teknik ini sangat berguna ketika format, nada, atau batas klasifikasi sulit dijelaskan. Dua hingga lima contoh yang tajam sering lebih berguna daripada penjelasan abstrak yang panjang.
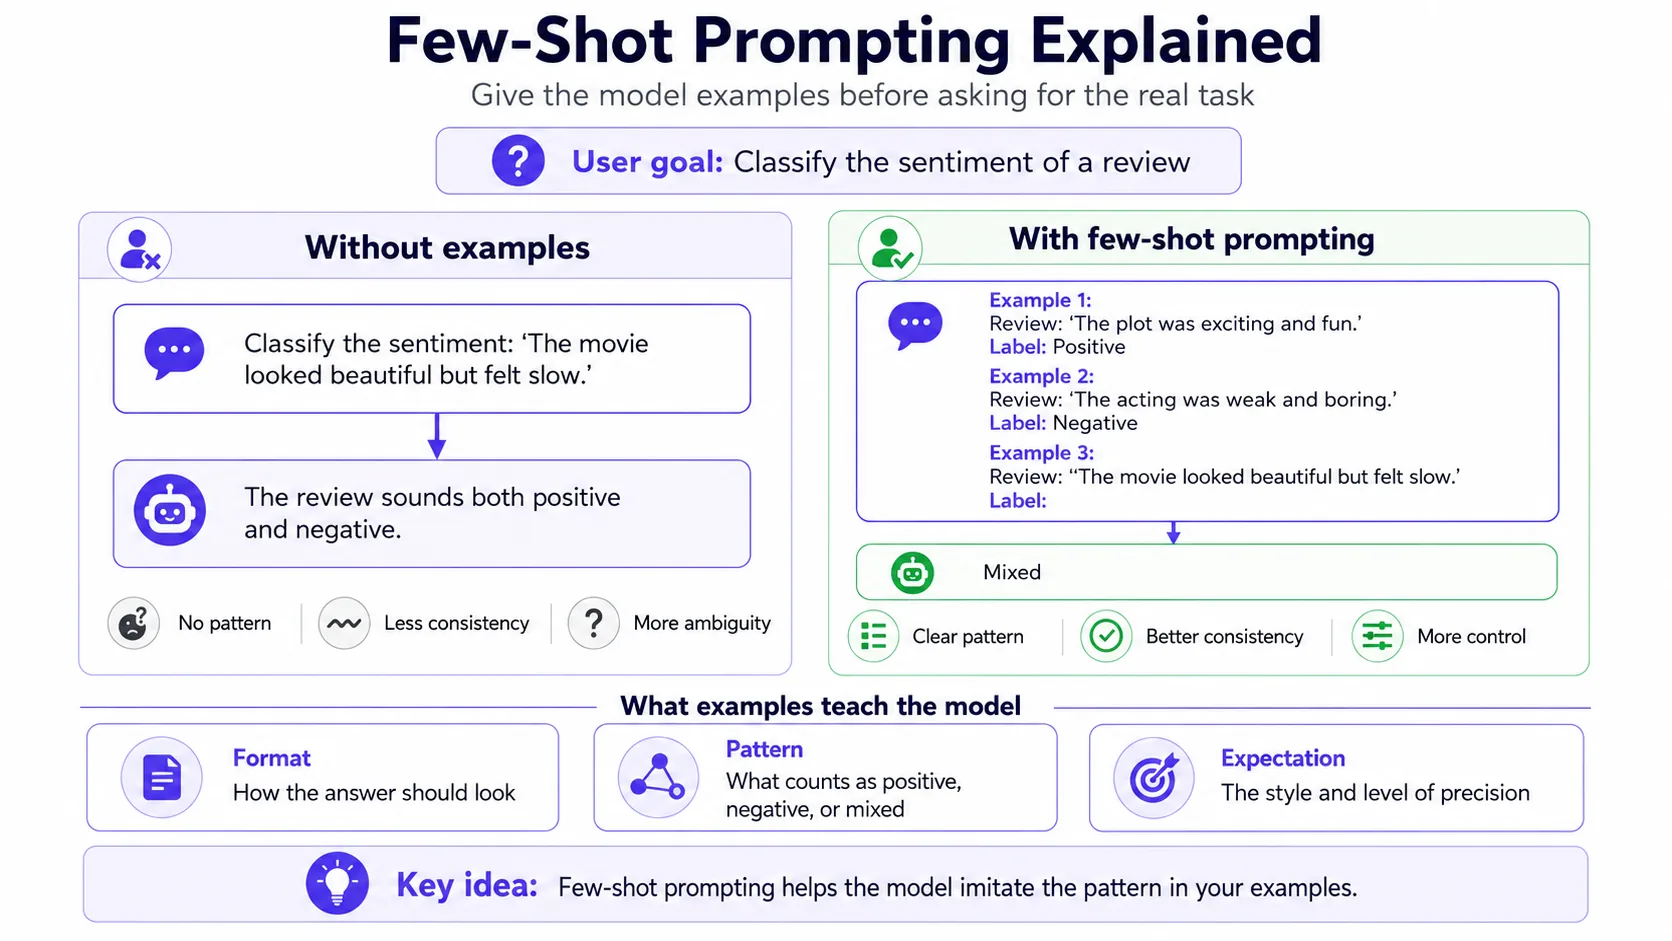
Penjelasan tentang Prompt Chaining
Prompt chaining memecah tugas kompleks menjadi langkah-langkah yang lebih kecil. Alih-alih meminta riset, outline, draf, kritik, dan versi final sekaligus, Anda menjalankan rangkaian: ekstrak fakta, buat struktur, tulis draf, evaluasi, revisi. Ini memberi kontrol lebih baik dan membuat kesalahan lebih mudah ditemukan.
Gabungkan teknik prompting menjadi sistem yang dapat diuji, disempurnakan, diberi retrieval, dan digunakan kembali.
Gagasan yang lebih kuat: rancang prompt operating system
Untuk pekerjaan berulang, prompt terbaik jarang hanya berupa satu kalimat cerdas. Perlakukan prompt seperti operating system kecil: peran, input, aturan sumber, standar kualitas, format output, dan langkah review. Dengan begitu alur kerja lebih mudah diajarkan dan di-debug.
“Tulis email onboarding kami.” Model harus menebak audiens, nada, detail produk, dan kriteria keberhasilan.
“Gunakan segmen pelanggan, janji produk, panduan nada, klaim yang dilarang, contoh email, dan checklist di bawah ini. Buat draf, lakukan self-review, lalu keluarkan email final.”
Penjelasan tentang Context Engineering
Context engineering adalah disiplin untuk menentukan informasi apa yang masuk ke model pada saat yang tepat. Ini mencakup pemilihan sumber, hierarki instruksi, memory, retrieval, contoh, tool, dan skema output. Tujuannya bukan “konteks sebanyak mungkin”; tujuannya adalah konteks terkecil yang tetap andal.
Cara menguji prompt
Pengujian prompt berarti menjalankan tugas yang sama pada contoh-contoh yang mewakili kondisi nyata, lalu memberi skor pada output. Gunakan rubrik: akurasi, kelengkapan, kepatuhan format, nada, keamanan, dan waktu edit. Simpan regression set kecil agar Anda tahu ketika perubahan prompt memperbaiki satu kasus tetapi merusak kasus lain.
Cara mendapatkan jawaban AI yang lebih baik
Jawaban yang lebih baik biasanya berasal dari tujuan yang lebih jelas, konteks yang lebih baik, batasan eksplisit, contoh, dan langkah review. Minta model menyatakan asumsi, menggunakan format tertentu, dan menandai ketidakpastian. Untuk fakta penting, berikan sumber atau minta kutipan dari materi hasil retrieval.
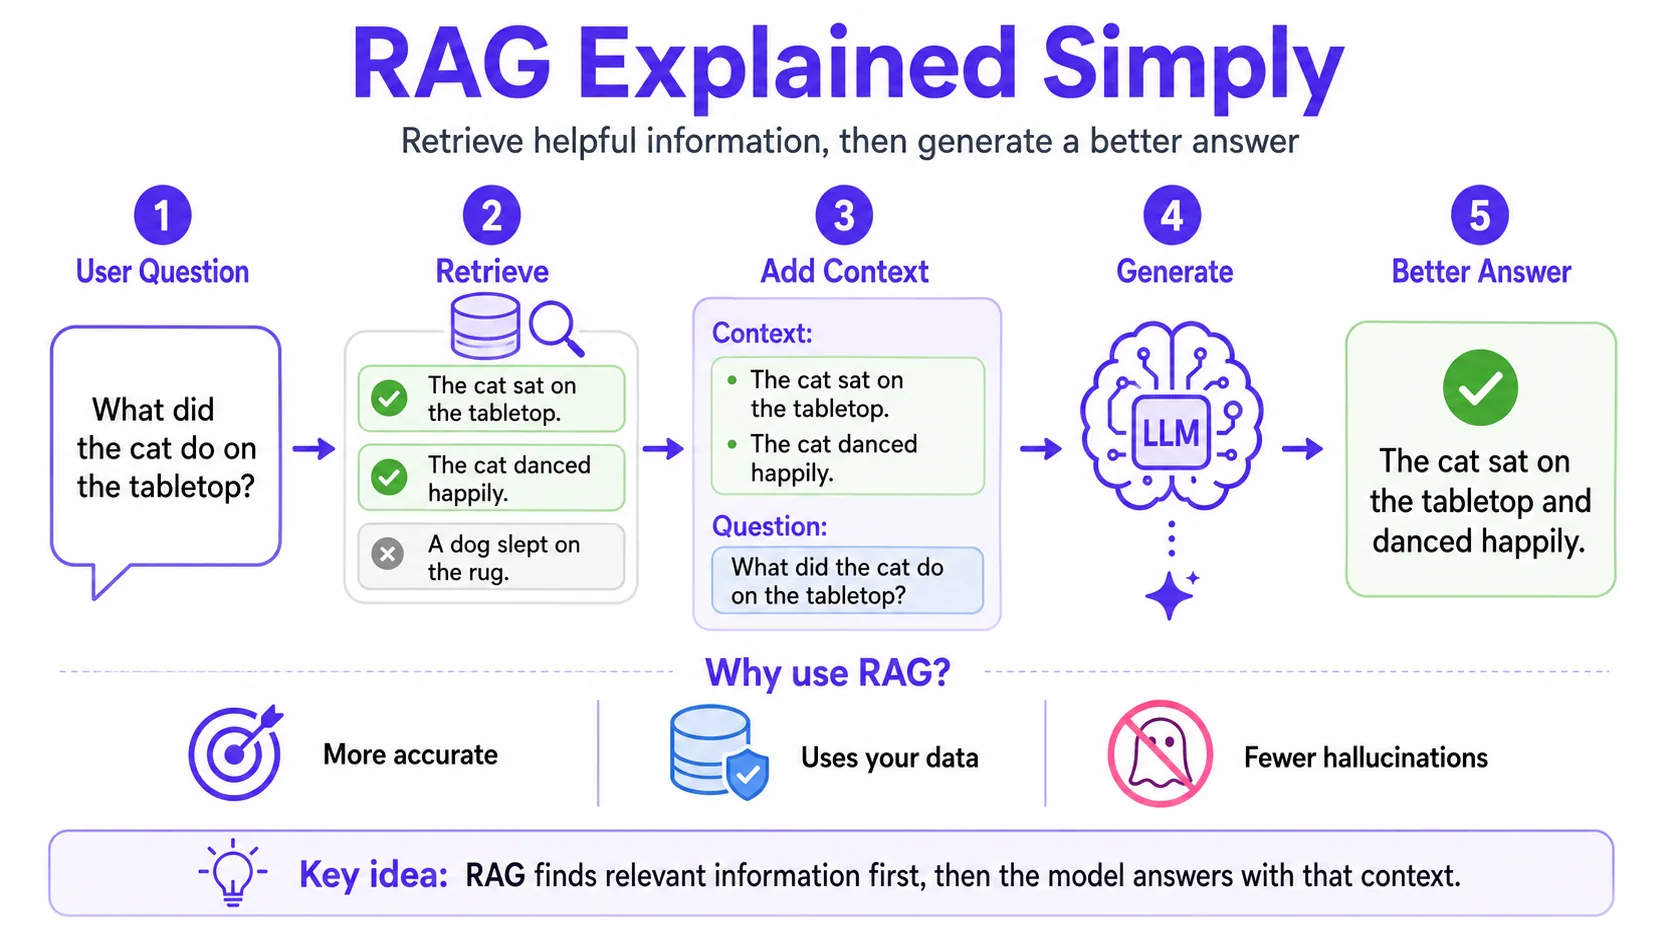
RAG dijelaskan secara sederhana
RAG adalah retrieval-augmented generation. Sistem terlebih dahulu mencari knowledge base, lalu memberikan bagian yang relevan kepada model, kemudian model menulis jawaban yang berlandaskan bagian tersebut. RAG berguna ketika jawaban bergantung pada dokumen privat, berubah-ubah, atau berukuran besar. RAG tidak diperlukan untuk tugas menulis yang sederhana.
Apa itu agen AI?
Sampai di sini Anda menulis prompt yang menghasilkan satu jawaban. Agen AI melangkah lebih jauh: agen dapat merencanakan beberapa langkah, menggunakan tool (seperti pencarian atau kalkulator), melihat hasilnya, lalu memutuskan apa yang harus dilakukan berikutnya — berulang sampai tugas selesai. Bayangkan perbedaan antara meminta petunjuk arah dan menyerahkan kunci agar seseorang menyelesaikan urusan itu untuk Anda.
Agen berguna untuk pekerjaan multi-langkah yang jika tidak akan membutuhkan banyak prompt terpisah: riset di beberapa halaman lalu merangkum; atau mencari sesuatu lalu menulis draf balasan berdasarkan hasilnya. Trade-off-nya adalah kontrol — karena agen dapat bertindak sendiri, Anda perlu memberi batas yang lebih jelas dan sering kali langkah review sebelum hal penting dilakukan. Jika Anda ingin detail teknis tentang cara kerja agen, tool, dan Large Action Models, panduan lanjutan membahasnya lebih dalam.
Temperature dijelaskan secara sederhana
Temperature mengontrol seberapa banyak variasi acak yang digunakan model saat memilih token. Temperature yang lebih rendah cenderung lebih mudah diprediksi dan konsisten. Temperature yang lebih tinggi dapat menghasilkan variasi dan kreativitas lebih besar, tetapi juga dapat meningkatkan penyimpangan dari instruksi. Ini bukan tombol kualitas; ini tombol variasi.
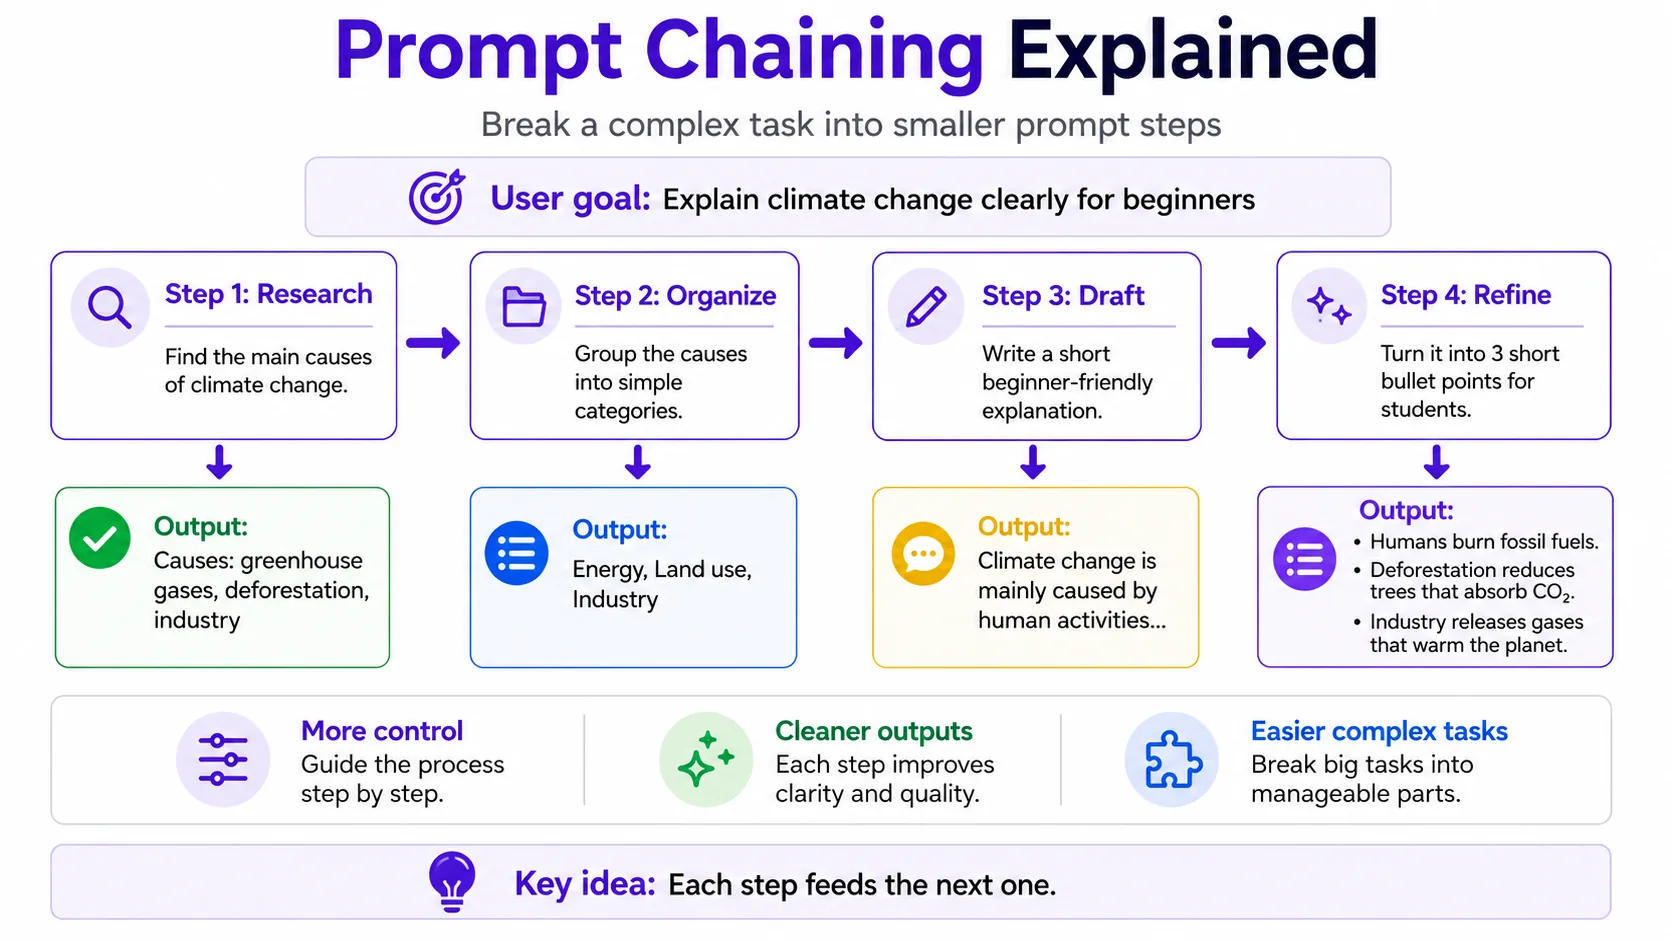
Cara model memilih setiap kata: greedy, top-k, dan top-p
Temperature adalah salah satu kontrol dalam langkah yang lebih besar yang disebut decoding (atau sampling). Pada setiap posisi, model menetapkan probabilitas untuk setiap token berikutnya yang mungkin, lalu metode decoding menentukan kandidat mana yang benar-benar dipilih. Pengaturan ini menjelaskan mengapa prompt yang sama dapat terasa kaku, sedikit repetitif, atau sangat kreatif tergantung konfigurasi API.
Metode umum, dari yang paling ketat hingga fleksibel:
Pilih token dengan probabilitas tertinggi pada setiap langkah. Ini menghilangkan randomness sampling untuk decoder tersebut, tetapi output identik tetap tidak dijamin di seluruh versi model, implementasi numerik, perubahan backend, atau infrastruktur yang nondeterministik.
Simpan hanya k token yang paling mungkin, misalnya 40, lalu pilih di antara token tersebut. Ukuran shortlist tetap sama meskipun tingkat keyakinan model berubah.
Simpan himpunan token terkecil yang total probabilitasnya mencapai p, misalnya 0,9. Shortlist menyusut saat model yakin dan membesar saat model tidak yakin.
Opsi yang lebih baru: simpan token yang mencapai setidaknya sebagian tertentu dari probabilitas token teratas. Pendekatan ini cenderung lebih stabil daripada top-p saat temperature tinggi.
Pengaturan ini saling berinteraksi, tetapi urutan persis dan kontrol yang tersedia bergantung pada implementasi. Dalam pipeline umum, temperature melakukan rescaling logits sebelum filter top-k atau top-p; runtime lain dapat menggabungkan atau mengurutkan processor secara berbeda. Sebagian provider menyarankan mengubah temperature atau top-p, bukan keduanya sekaligus, tetapi ikuti dokumentasi untuk model dan API yang Anda gunakan.