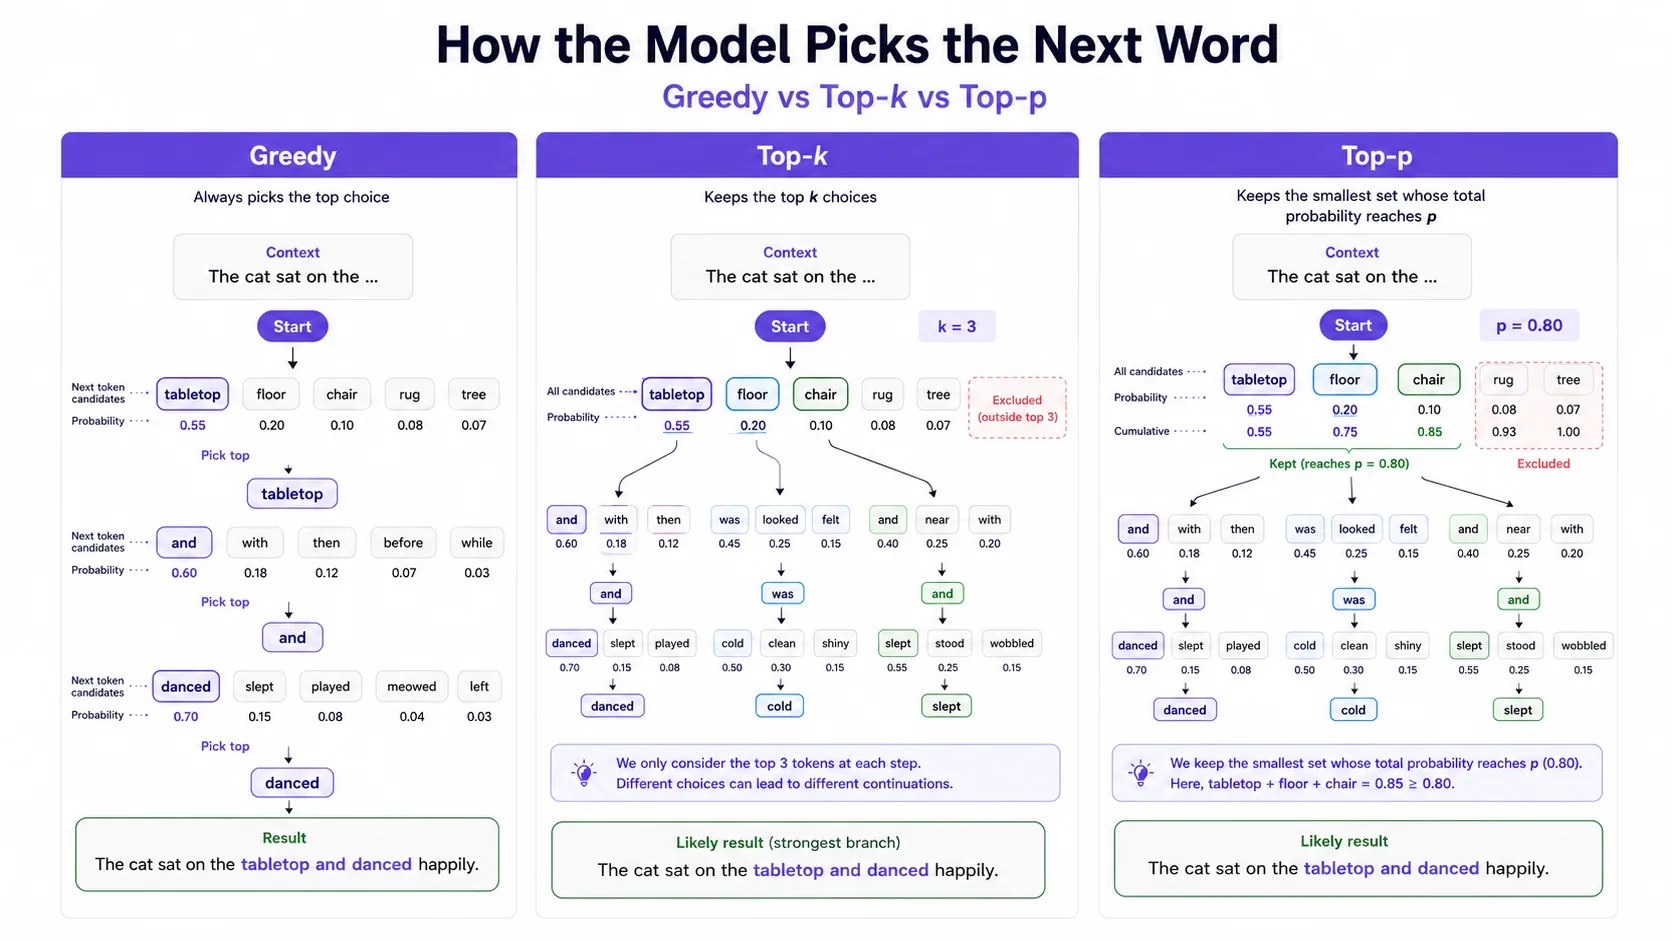
Paliwanag sa role prompting
Sa role prompting, hinihiling mong sumagot ang model mula sa isang partikular na propesyonal na pananaw. Dapat may kaugnayan sa gawain ang role, hindi pang-arte lang. Kapaki-pakinabang ang “Gumanap bilang senior support operations manager” sa pagproseso ng mga ticket; karaniwang kaunti lang ang naidudulot ng “Gumanap bilang henyo.”
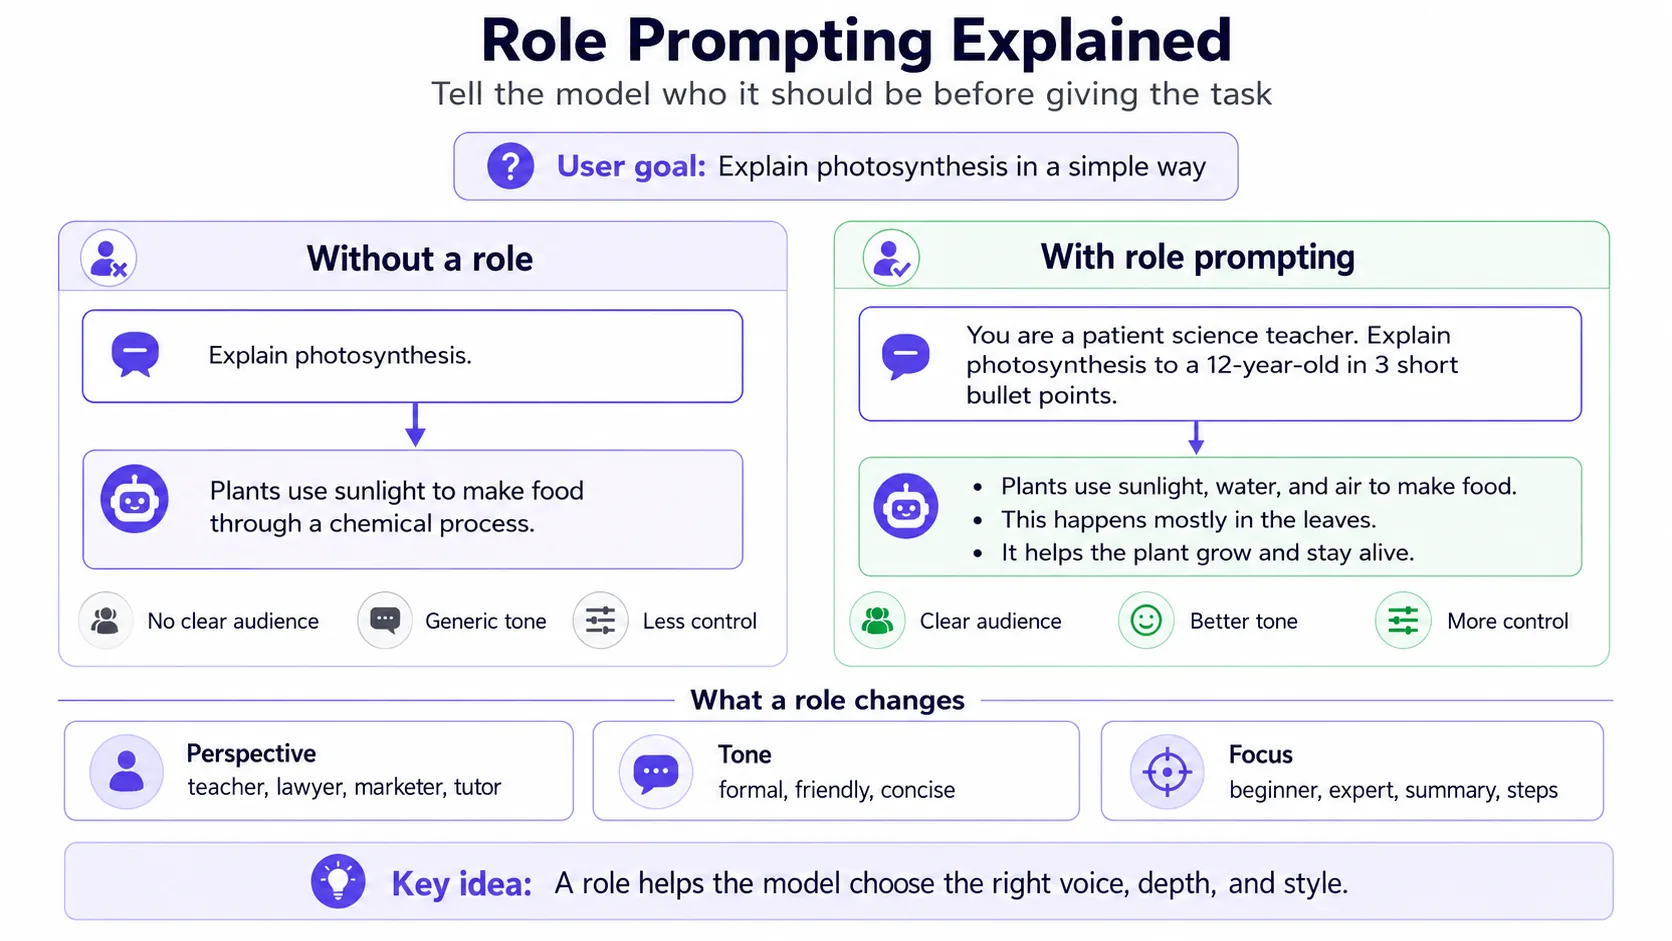
Paliwanag sa few-shot prompting
Sa few-shot prompting, nagbibigay ka ng ilang halimbawa ng input at ng nais na output. Lalo itong kapaki-pakinabang kapag mahirap ilarawan ang format, tono o hangganan ng mga kategorya. Madalas na mas mabuti ang dalawa hanggang limang malinaw na halimbawa kaysa sa mahabang abstraktong paliwanag.
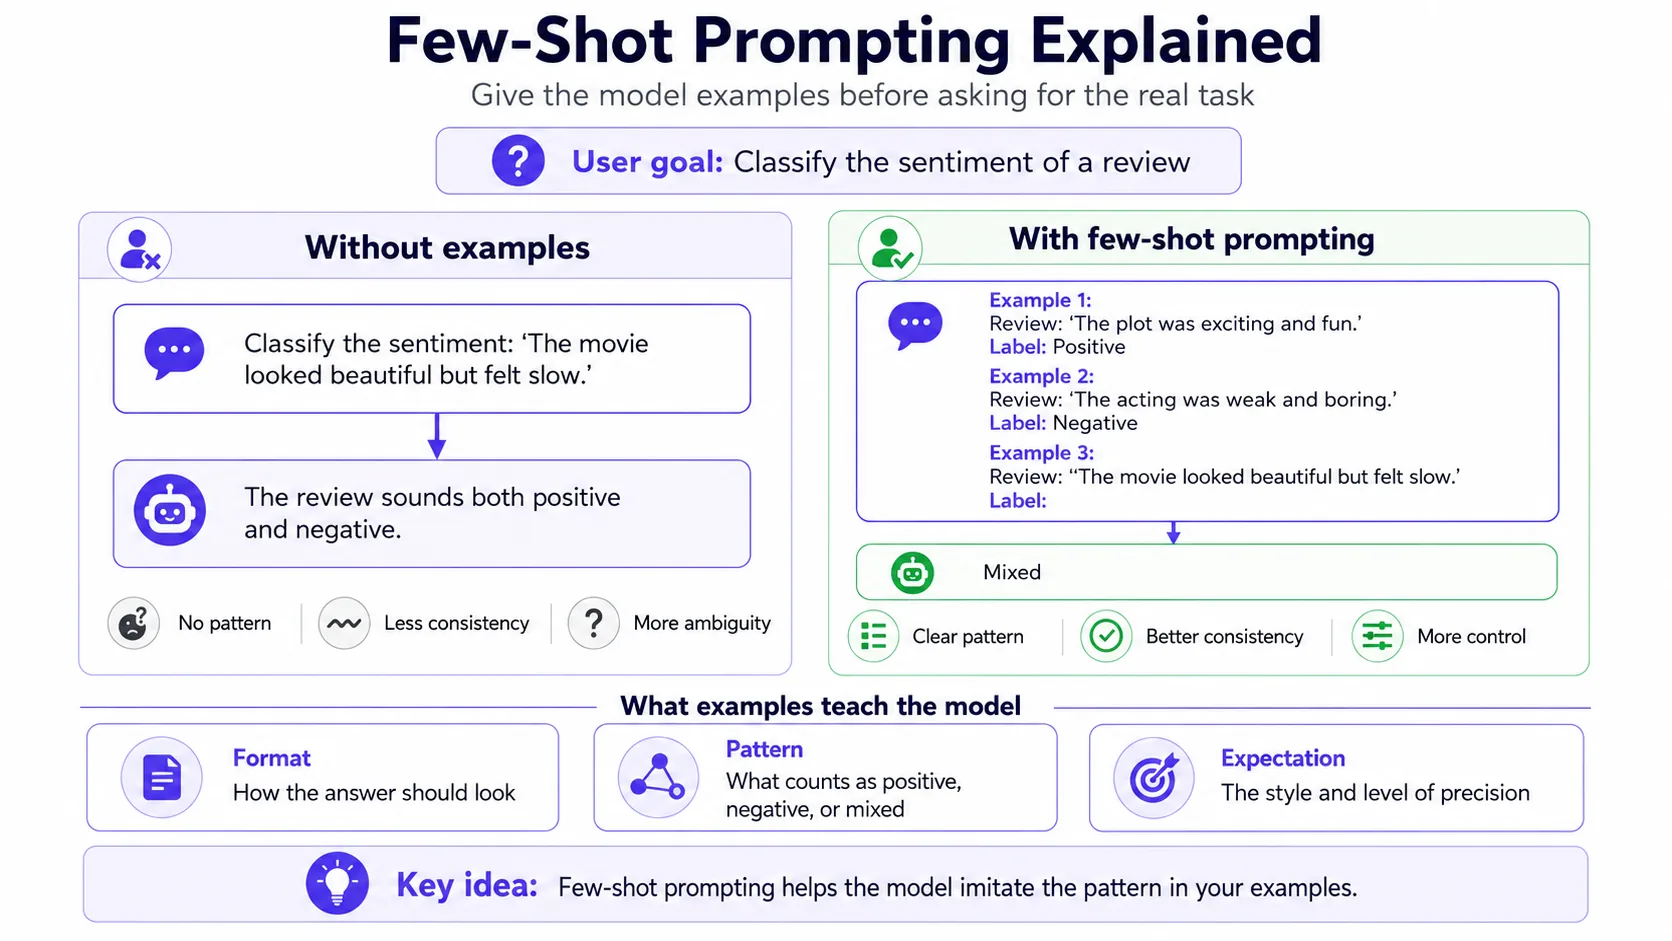
Paliwanag sa prompt chaining
Hinahati ng prompt chaining ang isang komplikadong gawain sa mas maliliit na hakbang. Sa halip na sabay na humingi ng research, outline, draft, critique at pinal na bersyon, sinusunod mo ang isang serye: kunin ang mga katotohanan, buuin ang istruktura, sumulat ng draft, suriin at baguhin. Mas madali nitong kontrolin ang proseso at mapansin ang mga pagkakamali.
Pagsamahin ang mga paraan ng prompting sa mga sistemang puwede mong subukan, paghusayin, hanapin muli at gamitin ulit.
Mas mahusay na ideya: magdisenyo ng prompt operating system
Para sa mga paulit-ulit na gawain, bihirang sapat ang isang matalinong pangungusap lang. Ituring ang prompt na isang maliit na operating system: role, mga input, tuntunin sa source, pamantayan ng kalidad, format ng output at hakbang sa pag-review. Sa ganitong paraan, mas madaling ituro at i-debug ang workflow.
“Isulat ang onboarding email namin.” Manghuhula ang model tungkol sa audience, tono, detalye ng produkto at pamantayan ng tagumpay.
“Gamitin ang customer segment, pangako ng produkto, tone guide, mga ipinagbabawal na claim, halimbawang email at checklist sa ibaba. Gumawa ng draft, suriin ito, saka ilabas ang pinal na email.”
Paliwanag sa context engineering
Ang context engineering ay ang maingat na pagpili kung aling impormasyon ang ipapasok sa model at kailan ito ipapasok. Kasama rito ang pagpili ng source, hierarchy ng mga tagubilin, memory, retrieval, mga halimbawa, tool at output schema. Hindi “pinakamaraming context” ang layunin, kundi ang pinakamaliit na context na mapagkakatiwalaan.
Paano subukan ang mga prompt
Sa prompt testing, pinapatakbo ang parehong gawain sa mga halimbawang kumakatawan sa tunay na paggamit at binibigyan ng score ang mga output. Gumamit ng rubric: katumpakan, pagkakumpleto, pagsunod sa format, tono, kaligtasan at oras ng pag-edit. Magtabi ng maliit na regression set para mapansin kung ang pagbabago sa prompt ay nagpapahusay sa isang kaso pero nakakasira sa iba.
Paano makakuha ng mas mahusay na sagot mula sa AI
Karaniwang nagmumula ang mas magagandang sagot sa mas malinaw na layunin, mas magandang context, tahasang limitasyon, mga halimbawa at hakbang sa pag-review. Hilingin sa model na sabihin ang mga palagay nito, gumamit ng tinukoy na format at markahan ang mga hindi tiyak. Para sa mahahalagang katotohanan, magbigay ng sources o humingi ng citations mula sa mga nakuhang materyal.
Simpleng paliwanag sa RAG
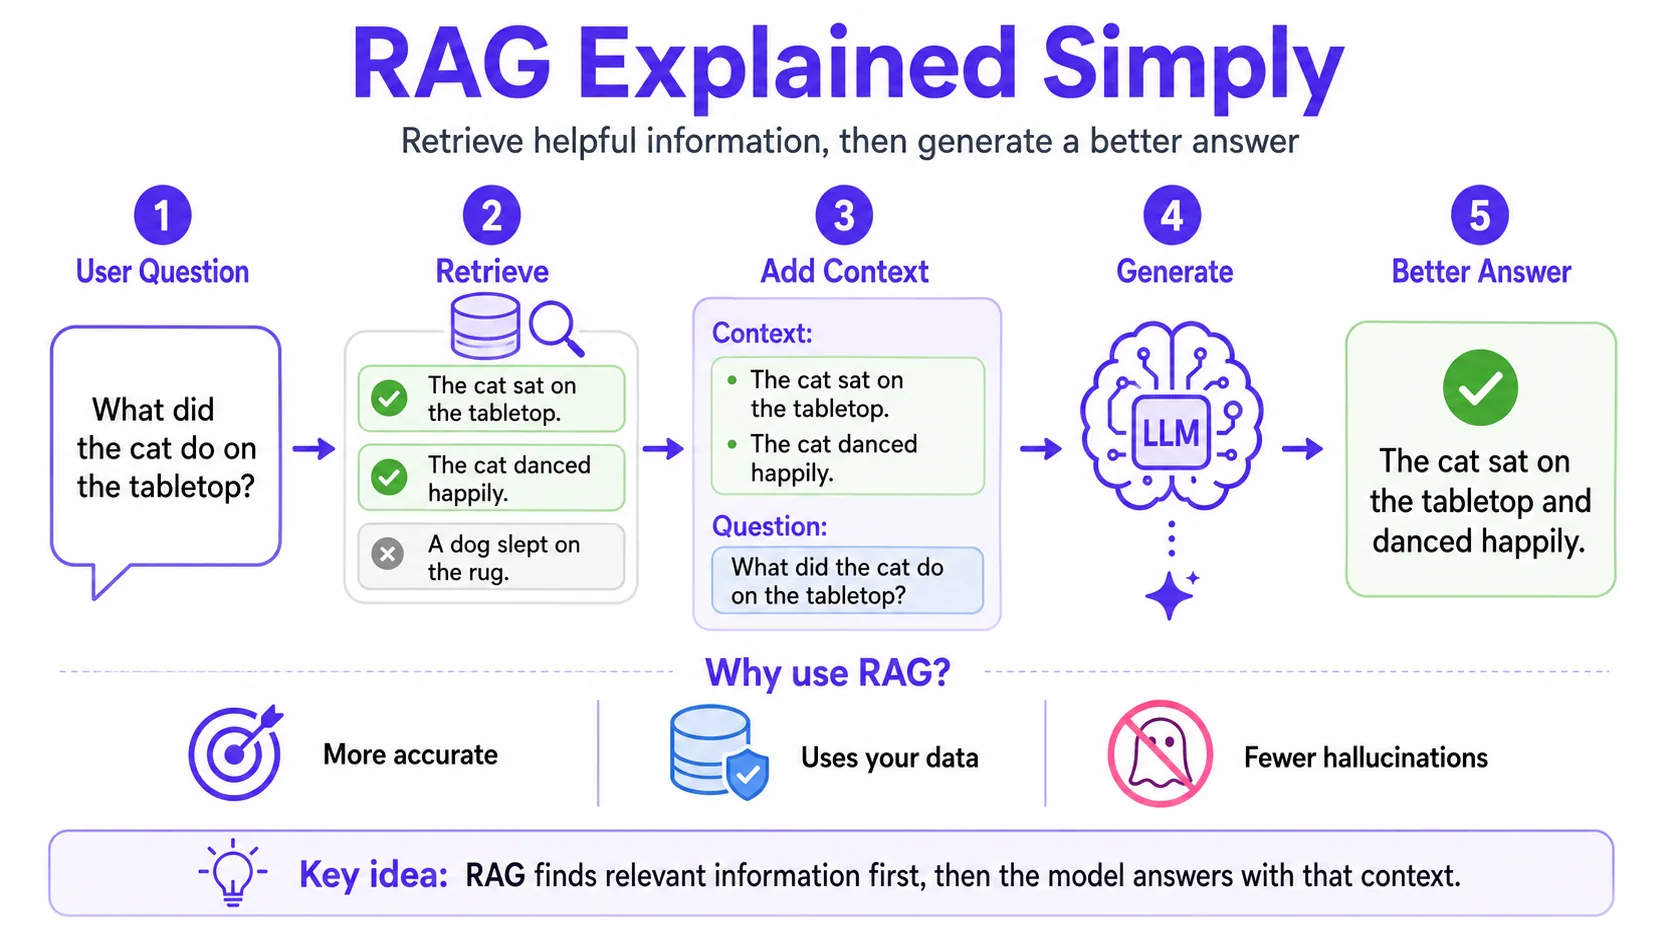
Ang RAG ay retrieval-augmented generation. Una, naghahanap ang system sa isang knowledge base. Pagkatapos, ipinapasa nito ang mga nauugnay na sipi sa model, na siyang sumusulat ng sagot batay sa mga siping iyon. Kapaki-pakinabang ang RAG kapag nakadepende ang sagot sa pribado, nagbabago o malalaking dokumento. Hindi ito kailangan para sa simpleng gawaing pagsusulat.
Ano ang mga AI agent?
Sa ngayon, ang mga prompt na isinulat mo ay humihingi ng isang sagot. Mas malayo ang kayang gawin ng AI agent: makakaplano ito ng ilang hakbang, makakagamit ng mga tool (gaya ng search o calculator), makakatingin sa resulta at makakapagpasya sa susunod na gagawin — paulit-ulit hanggang matapos ang gawain. Para itong pagkakaiba ng paghingi ng direksiyon at pagbibigay sa isang tao ng susi para siya mismo ang gumawa ng iniuutos.
Kapaki-pakinabang ang mga agent para sa mga gawaing may maraming hakbang na kung hindi ay mangangailangan ng maraming magkahiwalay na prompt: magsaliksik sa ilang pahina at saka magbuod, o maghanap muna ng impormasyon bago sumulat ng tugon batay rito. Kapalit nito ang mas kaunting direktang kontrol — dahil may sariling aksiyon ang agent, kailangan mong magtakda ng malinaw na hangganan at kadalasang mag-review bago may mangyaring mahalaga. Para sa teknikal na detalye kung paano gumagana ang mga agent, tool at Large Action Model, mas malalim itong tinatalakay sa advanced na gabay.
Simpleng paliwanag sa temperature
Kinokontrol ng temperature kung gaano kalaki ang randomness sa pagpili ng model ng mga token. Karaniwang mas predictable at consistent ang mas mababang temperature. Maaaring mas iba-iba at mas malikhain ang sagot sa mas mataas na temperature, pero maaari rin itong mas lumayo sa tagubilin. Hindi ito kontrol para sa kalidad; kontrol ito para sa pagkakaiba-iba.
Paano pinipili ng model ang bawat salita: greedy, top-k at top-p
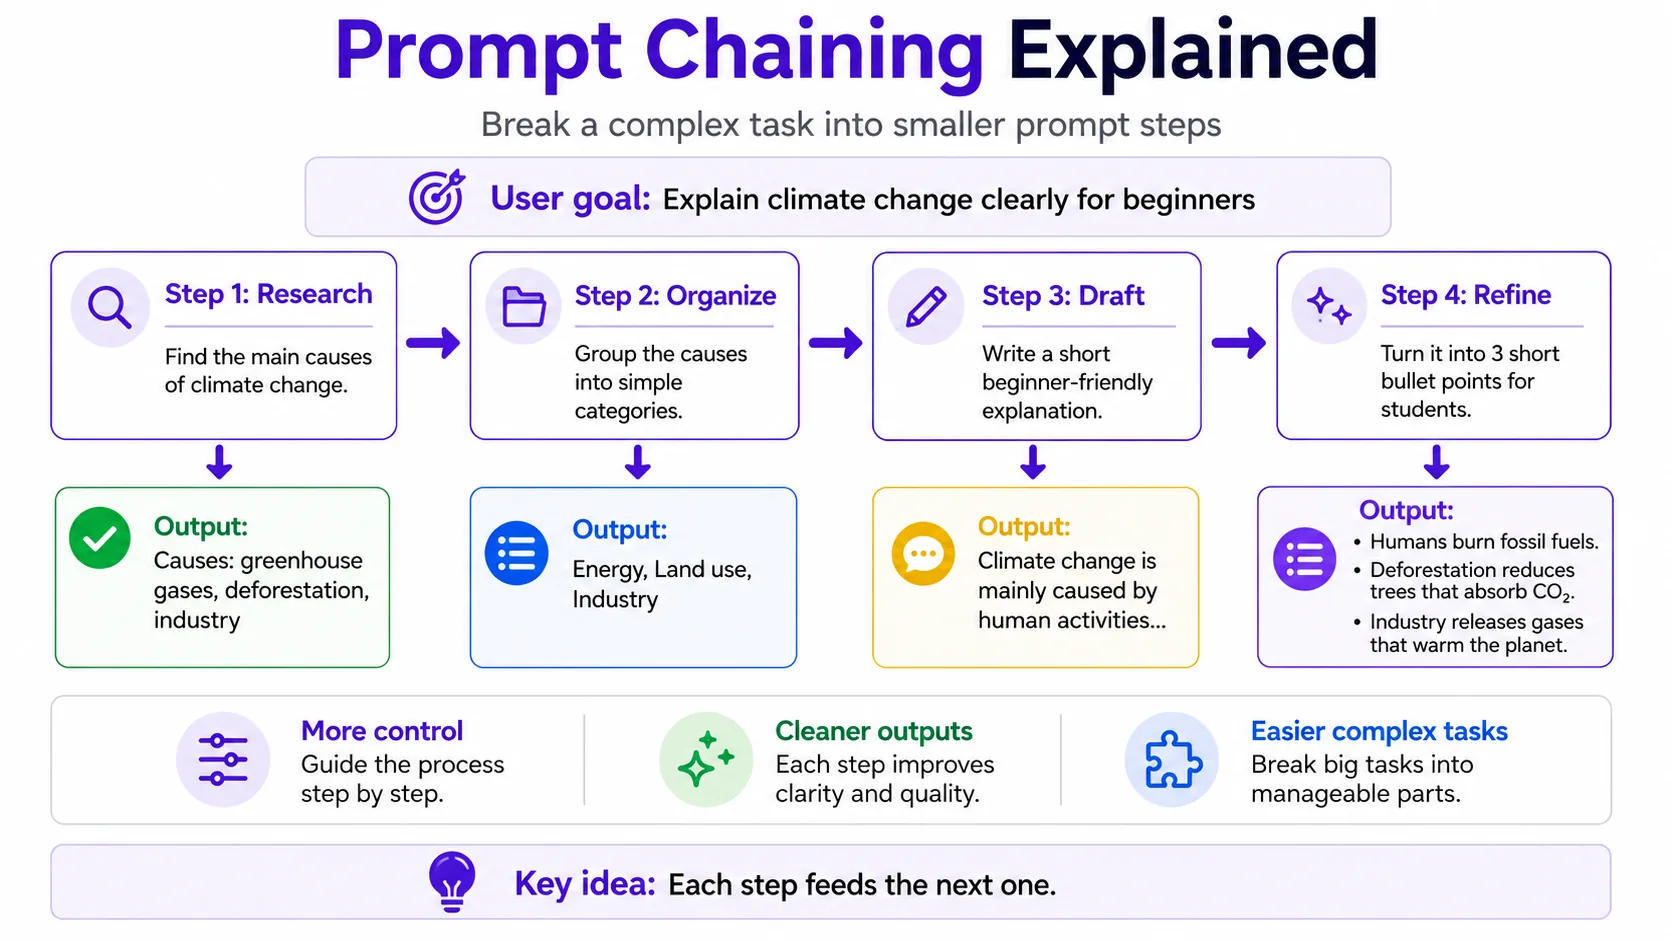
Isa lamang ang temperature sa mga control ng mas malawak na prosesong tinatawag na decoding (o sampling). Sa bawat posisyon, binibigyan ng model ng probability ang bawat posibleng susunod na token, at ang paraan ng decoding ang nagpapasya kung aling kandidato ang pipiliin. Ipinapaliwanag ng mga setting na ito kung bakit maaaring magmukhang sobrang istrikto, medyo paulit-ulit o napakalikhain ang parehong prompt depende sa configuration ng API.
Mga karaniwang paraan, mula sa pinakaistrikto hanggang sa mas flexible:
Pinipili ang token na may pinakamataas na probability sa bawat hakbang. Tinatanggal nito ang randomness ng sampling para sa decoder na iyon, pero hindi garantisadong magkakapareho ang output sa iba’t ibang bersyon ng model, numerical implementation, pagbabago sa backend o nondeterministic na infrastructure.
Ang k lang na pinaka-malamang na token ang natitira — halimbawa, 40 — at mula sa mga ito pipili. Pare-pareho ang laki ng shortlist kahit gaano katiyak ang model.
Pinananatili ang pinakamaliit na hanay ng mga token na ang kabuuang probability ay umaabot sa p, halimbawa ay 0.9. Umiikli ang shortlist kapag kumpiyansa ang model at humahaba kapag hindi ito tiyak.
Mas bagong opsiyon: pinananatili ang mga token na may probability na hindi bababa sa itinakdang bahagi ng probability ng nangungunang token. Karaniwang mas stable ito kaysa top-p kapag mataas ang temperature.
Nagkakaugnay ang mga setting na ito, pero nakadepende sa implementation ang eksaktong pagkakasunod-sunod at kung aling control ang available. Sa isang karaniwang pipeline, binabago ng temperature ang laki ng logits bago ang top-k o top-p filter; maaaring iba ang pag-ayos o pagsasama ng mga processor sa ibang runtime. Inirerekomenda ng ilang provider na baguhin ang temperature o top-p sa halip na pareho, pero sundin ang dokumentasyon para sa partikular na model at API.