Key-Value(KV) 캐시
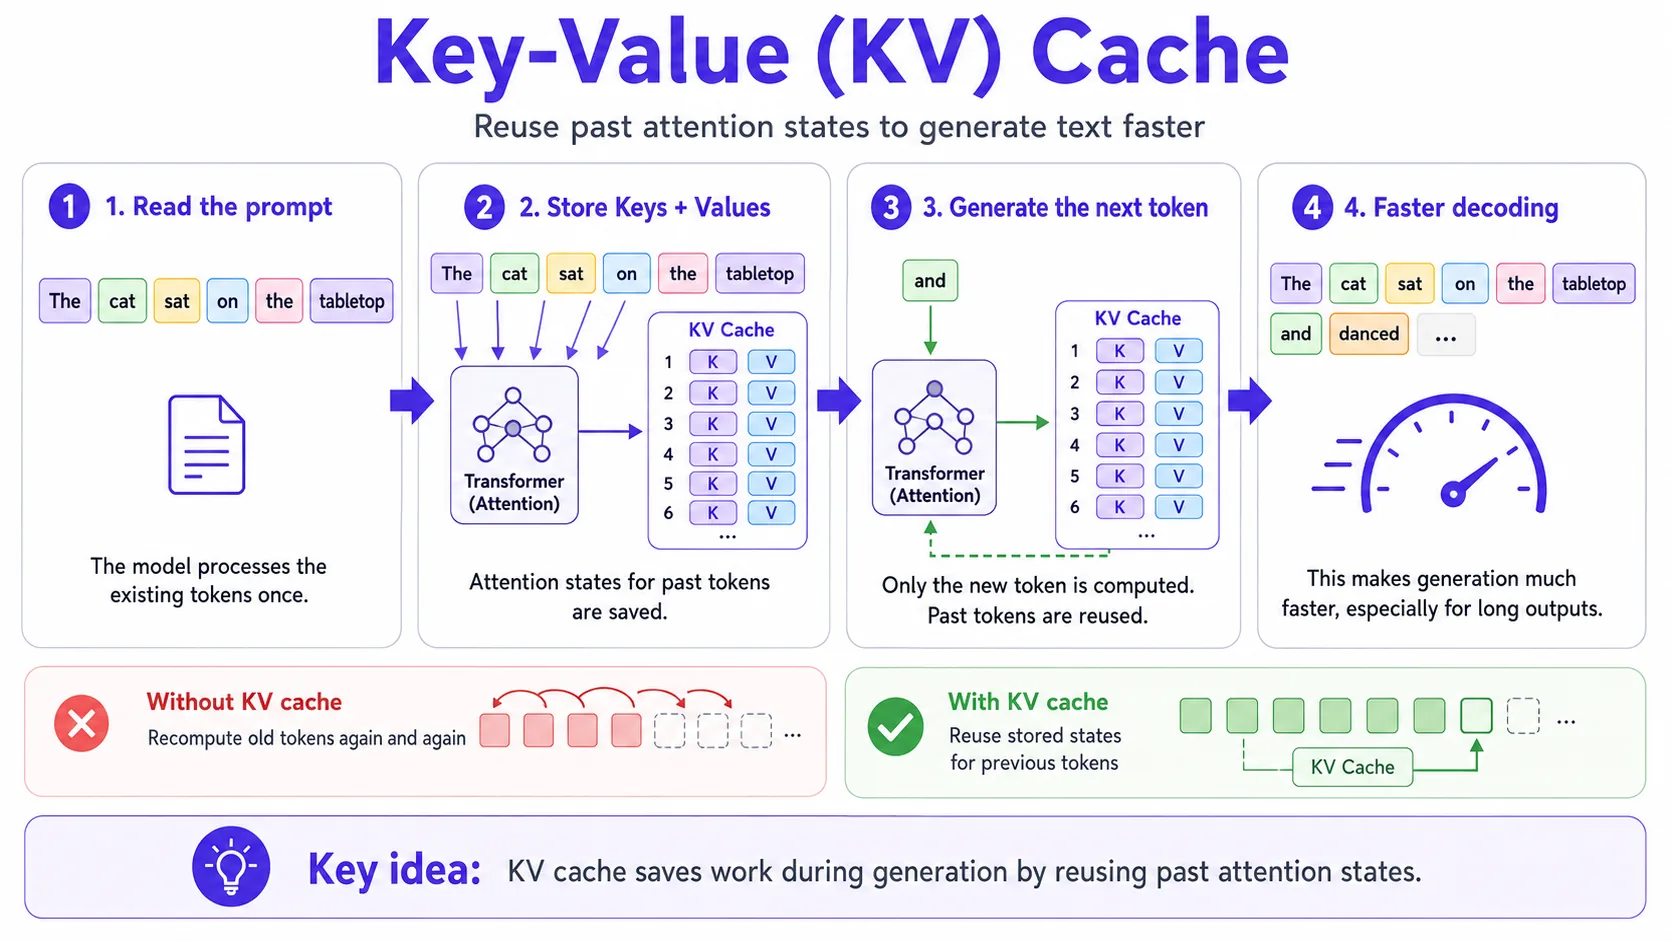
KV 캐시는 자기회귀 생성 중 이전 토큰의 key-value 텐서를 저장합니다. 새로운 토큰마다 전체 prefix를 다시 계산하는 대신 모델이 캐시된 표현을 재사용합니다. 긴 출력을 생성할 때 지연 시간을 줄일 수 있지만 활성 요청당 메모리 부담은 커집니다.
LLM 애플리케이션의 프로덕션 컨트롤 플레인
전문가 수준의 LLM 시스템은 완벽한 모델 하나보다 라우팅, 캐싱, 평가, 안전 검사, 피드백 루프가 더 중요합니다. 신뢰할 수 있는 플랫폼은 어떤 모델을 호출할지, 어떤 컨텍스트를 검색할지, 언제 더 저렴한 모델을 사용할지, 언제 에스컬레이션할지, 회귀를 어떻게 감지할지를 결정합니다.
요청을 정규화하고 rate limit을 적용하며 테넌트 메타데이터를 붙이고 후보 모델을 선택합니다.
작업 난이도, 지연 시간 예산, 위험도에 따라 소형, 대형 또는 특화 모델을 선택합니다.
검색 품질, 답변 품질, 인용의 충실성, 안전성, 스키마 유효성을 평가합니다.
프롬프트, 검색된 청크, 모델 버전, 토큰 수, 지연 시간 백분위, 실패 유형을 추적합니다.
Mixture of Experts
Mixture of Experts는 토큰이나 예시를 일부 전문 expert 네트워크로 라우팅합니다. 모든 토큰에 모든 파라미터를 사용하지 않고도 전체 파라미터 수를 늘릴 수 있습니다. 대신 라우팅 복잡성, 부하 분산, 통신 오버헤드, 더 어려운 디버깅이라는 트레이드오프가 있습니다.
추측 디코딩
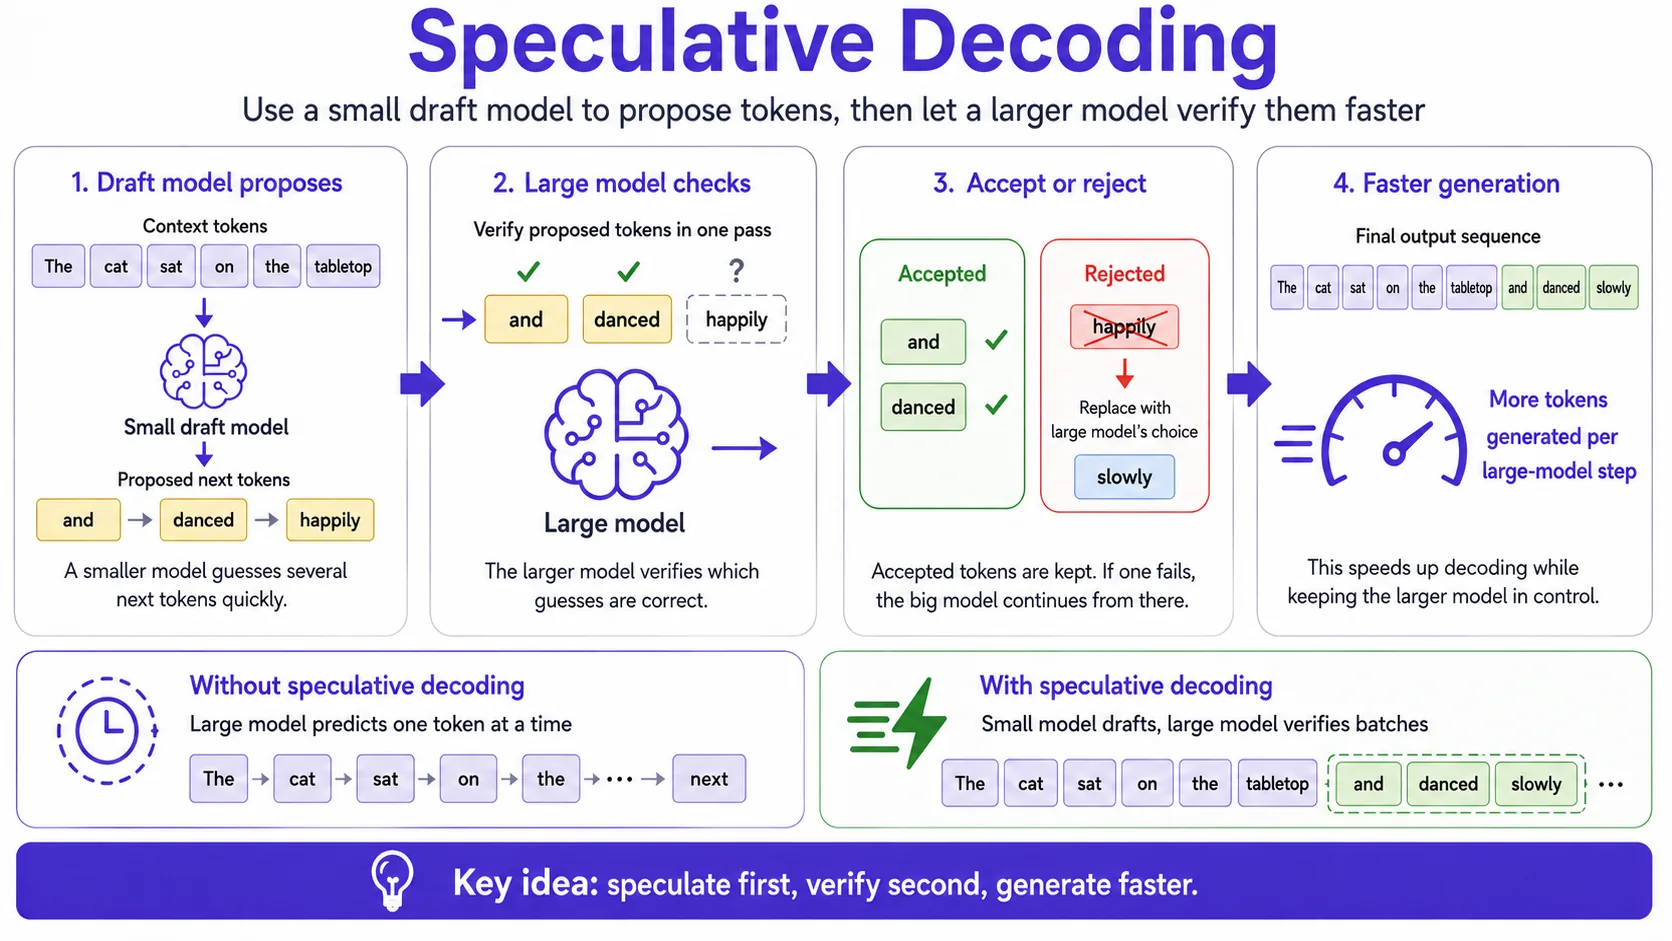
추측 디코딩은 draft 모델이나 draft 절차가 토큰을 제안하고 target 모델이 이를 검증하도록 합니다. 정확한 speculative sampling 알고리즘은 target 모델의 출력 분포를 보존할 수 있지만, 휴리스틱 변형은 정확성을 일부 포기하고 속도를 얻을 수 있습니다. 속도 향상 폭은 수용률, draft 비용, 시퀀스와 배치 형태, 런타임, 하드웨어에 따라 달라집니다.
양자화
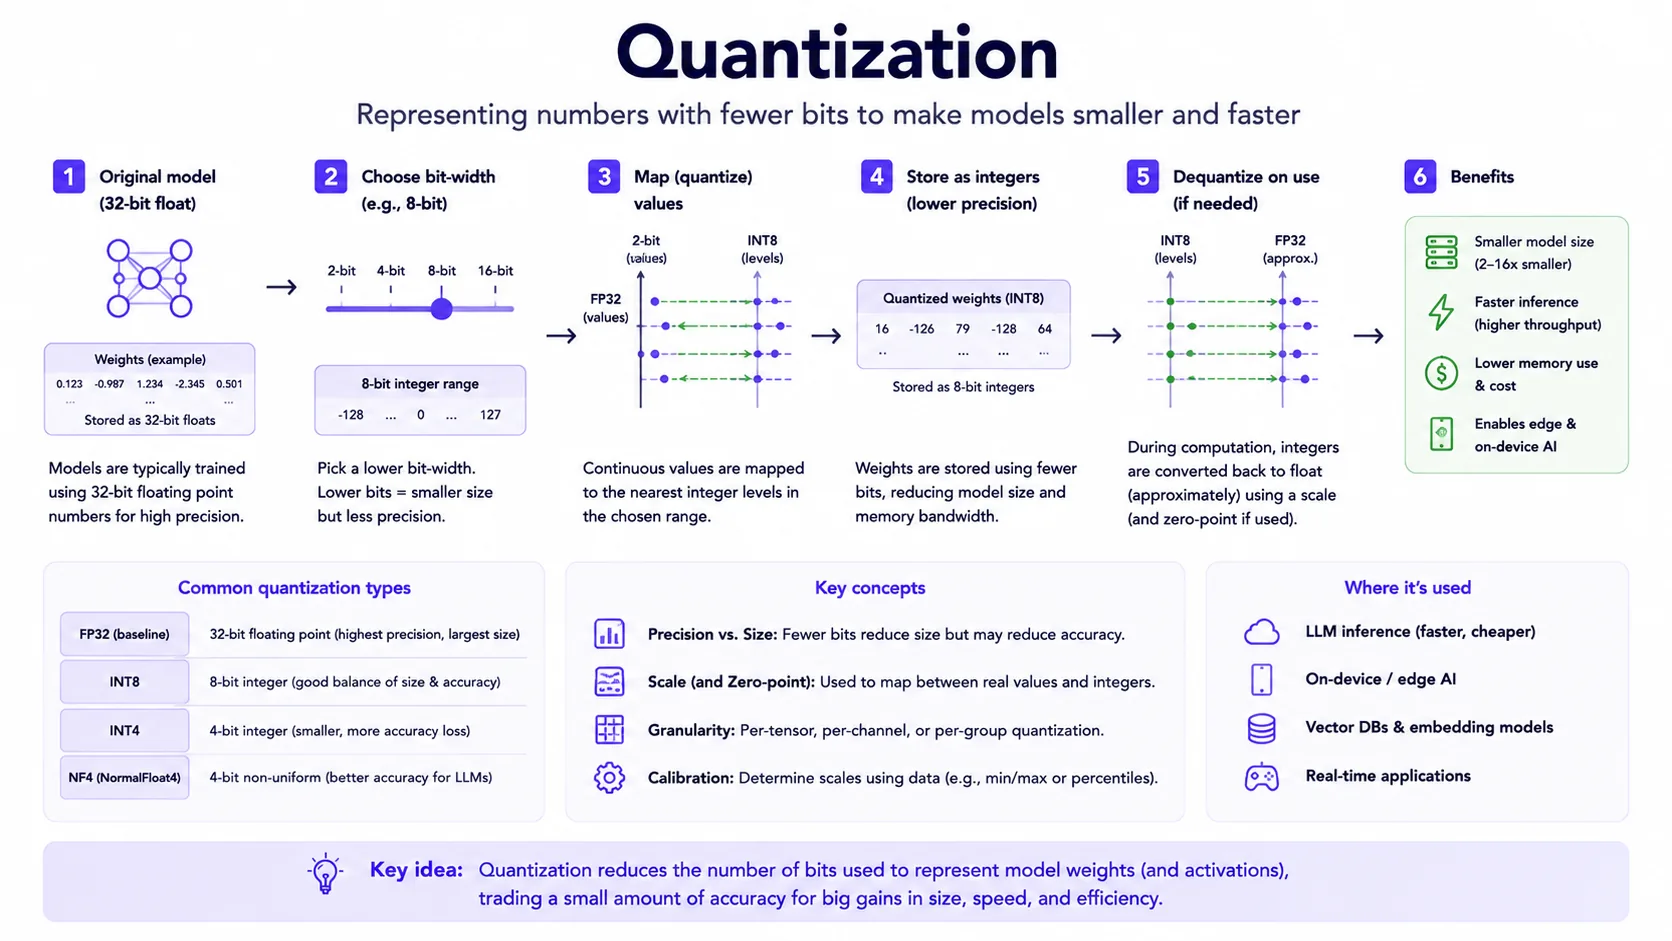
양자화는 모델 가중치, activation 또는 캐시의 정밀도를 예를 들어 16비트에서 8비트나 4비트로 낮춥니다. 선택한 형식을 하드웨어, 커널, 런타임, 워크로드가 지원하면 메모리 사용량을 줄이고 처리량을 높일 수 있습니다. 반대로 품질, calibration, 도구 호출 신뢰성을 떨어뜨릴 수도 있습니다.
LoRA와 파인튜닝
LoRA는 일반적으로 베이스 모델을 고정한 채 low-rank adapter 파라미터를 학습해 전체 파인튜닝보다 학습 대상 파라미터 수와 메모리 요구량을 줄입니다. 행동, 스타일, 형식, 작업 또는 도메인 적응에 유용하지만 사실이 자주 바뀌는 상황에서 검색을 신뢰성 있게 대체하지는 못합니다. 지식 적응 역시 데이터, 학습 설정, 평가에 따라 달라집니다.
모델 최적화에서 선호도 튜닝, 관찰 가능성, 평가, 안전, 라우팅, 비용 제어로 확장하세요.
Direct Preference Optimization(DPO)과 인간 피드백 기반 강화학습(RLHF)
RLHF와 DPO는 사람의 피드백 또는 선호도 데이터를 사용해 모델 행동을 최적화합니다. RLHF에는 일반적으로 reward modeling과 policy optimization이 포함됩니다. DPO는 더 단순한 목적 함수로 선호도를 직접 최적화합니다. 두 방식 모두 선호도 데이터의 품질에 의존하며 평가자가 보상하는 패턴에 과적합될 수 있습니다.
LLM 관찰 가능성
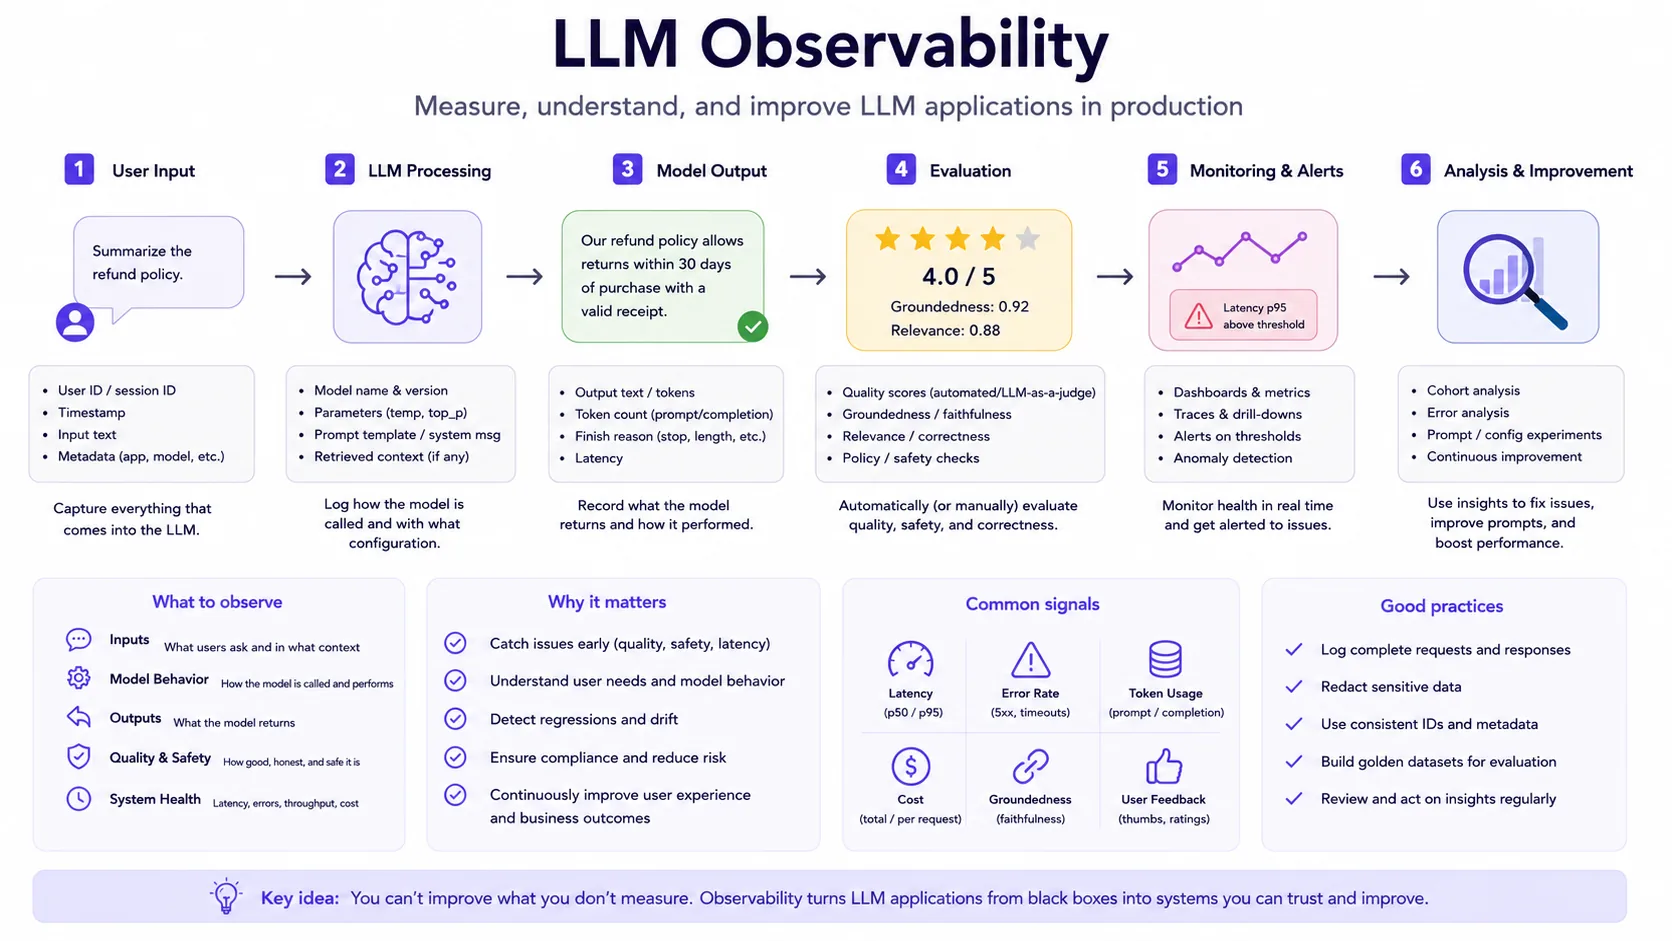
LLM 관찰 가능성은 프롬프트, 검색 결과, 도구 호출, 지연 시간, 비용, 사용자 피드백, 안전 이벤트, 평가 점수를 추적합니다. 로그는 개인정보를 고려해야 합니다. 디버깅에 필요한 정보는 충분히 기록하되 불필요한 민감 정보는 저장하지 않아야 합니다.
검색 증강 생성(RAG) 평가
RAG 평가는 검색 품질과 답변 품질을 분리해 봅니다. 올바른 문서를 찾았는지, 답변이 그 문서를 사용했는지, 인용이 주장을 뒷받침하는지, 최종 출력이 작업 요구를 충족하는지 측정하세요.
프로덕션 스택 밖에서 응답을 평가하는 구체적인 예시는 응답 품질 테스트에서 확인할 수 있습니다. 여기서는 동일한 프롬프트를 네 가지 어시스턴트에서 비교합니다.
모델 라우팅
모델 라우팅은 각 작업을 요구 수준을 충족하는 가장 저렴한 모델이나 워크플로로 보냅니다. 단순 분류에는 작은 모델을, 복잡한 추론에는 더 강한 모델을 사용할 수 있으며, 위험도가 높은 답변에는 검색과 검토가 필요할 수 있습니다. 품질 제어가 잘못된 라우팅을 잡아낼 때만 비용 절감 효과가 있습니다.
AI 안전 레드팀 테스트
레드팀 테스트는 적대적이거나 비정상적인 입력에서 시스템이 어떻게 실패하는지 확인합니다. LLM 앱에서는 프롬프트 인젝션, 데이터 유출, 안전하지 않은 도구 사용, 정책 우회, 숨겨진 지시, 사회공학 프롬프트를 테스트하세요. 목표는 완벽함을 증명하는 것이 아니라 통제 장치를 개선하는 것입니다.
대규모 언어 모델(LLM) 앱 비용 최적화
비용 최적화는 프롬프트 압축, 캐싱, 라우팅, 배칭, 컨텍스트 프루닝, 검색 품질, 양자화, 평가를 함께 고려합니다. 토큰당 비용만이 아니라 성공한 작업당 비용을 최적화하세요. 세 번 재시도가 필요한 저렴한 모델은 강한 모델을 한 번 쓰는 것보다 더 비쌀 수 있습니다.